La clasificación completa
Todos los modelos clasificados por su escritura en español, con filtros por tipo de texto, empresa, tamaño, razonamiento y cuantización, y las matrices de duelos.
Los nuevos modelos al entrar en la clasificación, su puesto frente a su predecesor, los nuevos análisis y los hitos del proyecto.
101.859 veredictos clasificados
108 modelos clasificados
faltan 23.141 para 125.000
Totales acumulados de la edición en español, día a día.
Puestos y puntuaciones son los de hoy: se recalculan con cada nuevo veredicto y no se congelan cuando llega un modelo.

MiniMax M3.1 Flash. Hoy en el puesto 93 de 108, con una puntuación de 11,2.
100.000
Alcanzado 85 días después del primer duelo, 16 días después del hito de 75.000.

Ling 3.1 Flash. Hoy en el puesto 20 de 108, con una puntuación de 83,8.

Mistral Large 4. Hoy en el puesto 48 de 108, con una puntuación de 55,6.
Nemotron 3 Ultra. Hoy en el puesto 69 de 108, con una puntuación de 37,9.
Nemotron 3.5 Lightning. Hoy en el puesto 82 de 108, con una puntuación de 17,4.

Claude Haiku 5.5. Hoy en el puesto 30 de 108, con una puntuación de 73,1.
Hasta ahora, la mayoría de los duelos comparaban mensajes personales. Los nuevos se reparten entre las diez categorías (cartas, artículos, ficción, discursos, informes…), empezando por las menos cubiertas: la clasificación reflejará poco a poco todos los tipos de texto.
Muse Spark 1.3, que retrocedía en la clasificación, deja de juzgar; sus veredictos anteriores siguen publicados. Claude Opus 5.5 asume su parte y los duelos llegan al mismo ritmo.
En el Duelo y en los cara a cara, las respuestas muestran ahora sus negritas, subtítulos y listas en lugar de asteriscos y almohadillas sin formato: se juzga el texto como lo vería un lector.
Cerca de un veredicto de cada veinte venía de un juez ante su propio modelo, que tendía a favorecerse: hasta cinco puntos en algunos modelos. Esos veredictos siguen publicados en la página de los jueces, pero ya no entran en la clasificación, y ningún juez recibe ya su propio modelo.

GPT-6.1 Sol. Hoy en el puesto 5 de 108, con una puntuación de 95,7. Son 3,2 puntos más que su predecesor, GPT-6 Sol (puesto 11, 92,5). Duelos directos ganados contra él: 10 de 21 (48 %).
100
Con Claude Sonnet 5.5, 72 días después del primer duelo.

Aion 3.5. Hoy en el puesto 17 de 108, con una puntuación de 85,0. Son 38,4 puntos más que su predecesor, Aion 3.0 (puesto 55, 46,6).
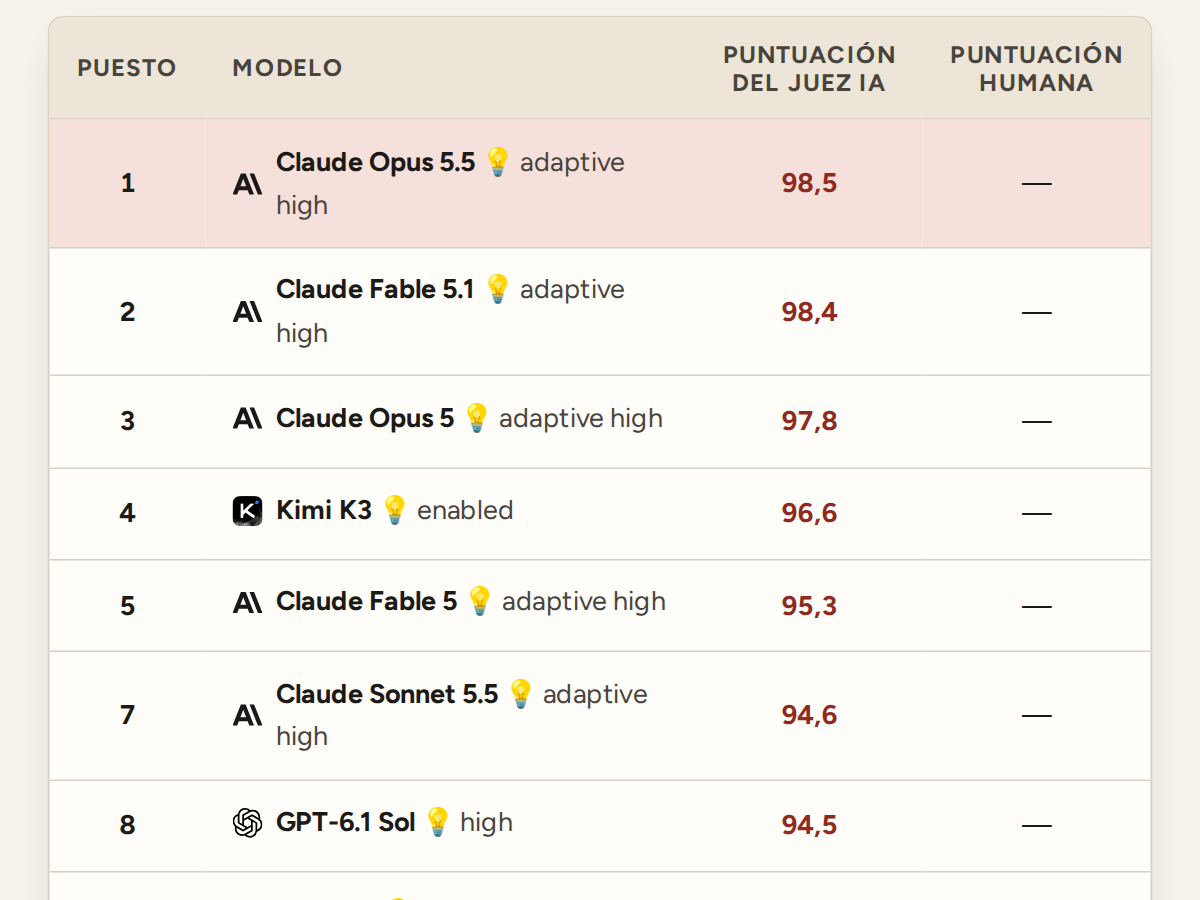
Claude Sonnet 5.5. Hoy en el puesto 10 de 108, con una puntuación de 93,7. Son 9,3 puntos más que su predecesor, Claude Sonnet 5 (puesto 19, 84,4).
La clasificación de IA local muestra la memoria que necesita cada modelo como archivo y con un contexto de 128K o 256K, en GGUF o MLX y con caché F16 o Q8. Unos botones sobre cada clasificación pasan de los modelos más recientes a la generación anterior o a los más antiguos.
75.000
Alcanzado 69 días después del primer duelo, 12 días después del hito de 50.000.
Claude Opus 5.5. Hoy en el puesto 1 de 108, con una puntuación de 98,5. Son 0,7 puntos más que su predecesor, Claude Opus 5 (puesto 3, 97,8).
GPT-6 Luna. Hoy en el puesto 24 de 108, con una puntuación de 81,8. Son 4,6 puntos más que su predecesor, GPT-5.6 Luna (puesto 27, 77,2).
GPT-6 Sol. Hoy en el puesto 11 de 108, con una puntuación de 92,5. Son 7,3 puntos más que su predecesor, GPT-5.6 Sol (puesto 16, 85,2).
Los últimos modelos de Anthropic y OpenAI toman el relevo como jueces, junto a Muse Spark 1.3. Cada veredicto sigue comparando dos textos anónimos escritos para la misma consigna.

Agnes 3.0 Flash. Hoy en el puesto 78 de 108, con una puntuación de 25,7.

Grok 4.7. Hoy en el puesto 13 de 108, con una puntuación de 88,8. Son 17,3 puntos más que su predecesor, Grok 4.6 (puesto 31, 71,5). Duelos directos ganados contra él: 6 de 10 (60 %).

MiMo V2.6 Flash. Hoy en el puesto 67 de 108, con una puntuación de 38,9.
MiMo V2.6 Pro. Hoy en el puesto 25 de 108, con una puntuación de 80,1. Son 37,8 puntos más que su predecesor, MiMo V2.5 Pro (puesto 62, 42,3). Duelos directos ganados contra él: 30 de 35 (86 %).
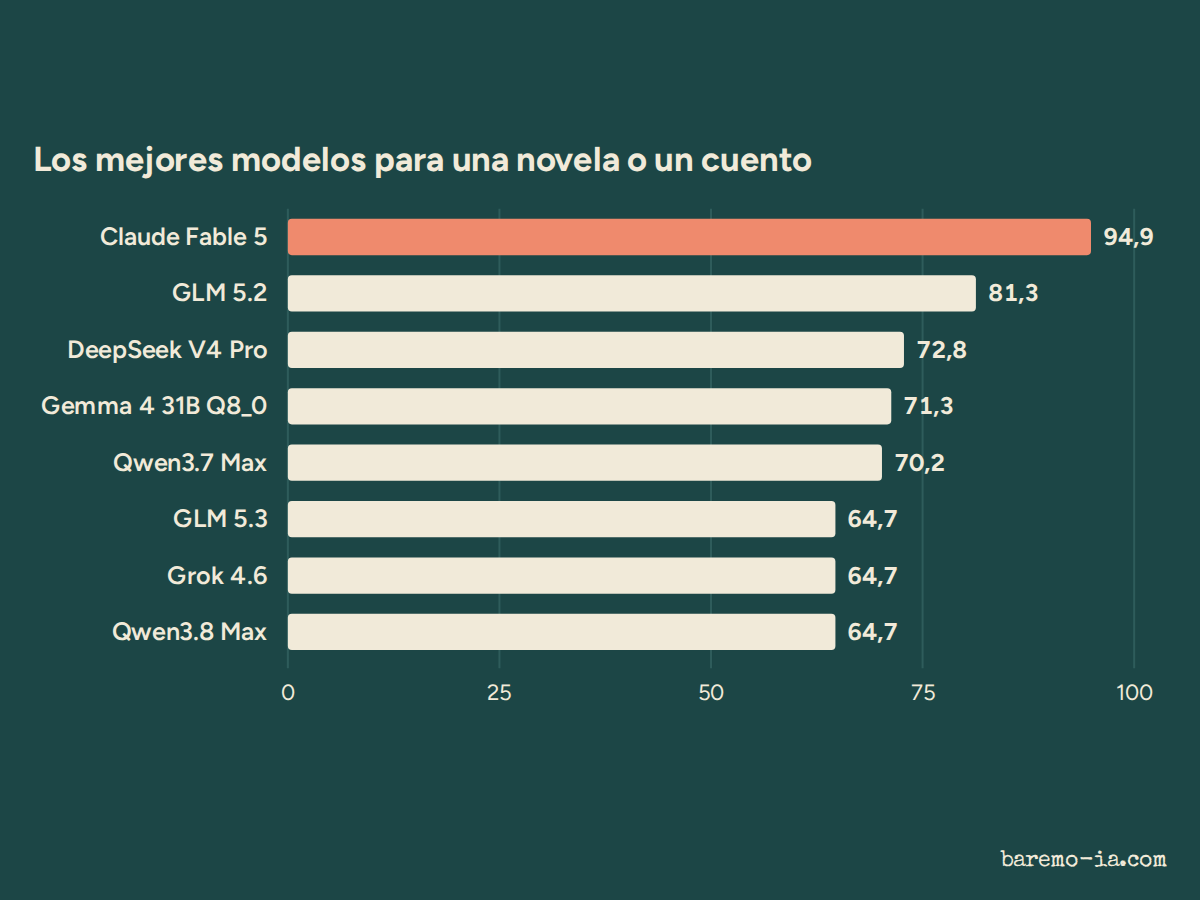 ¿Qué IA para una novela, un correo, una carta de presentación o un TFG? El mejor modelo cambia con el texto
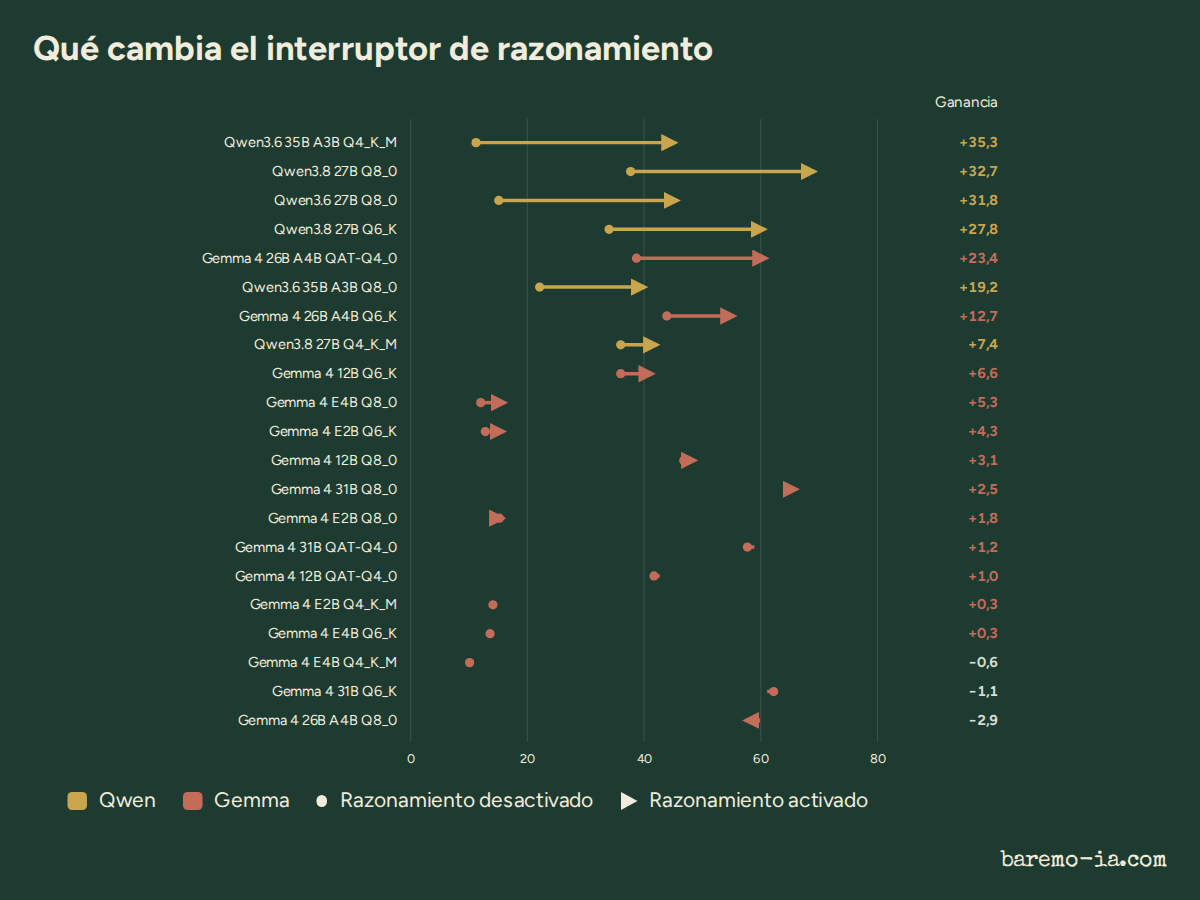
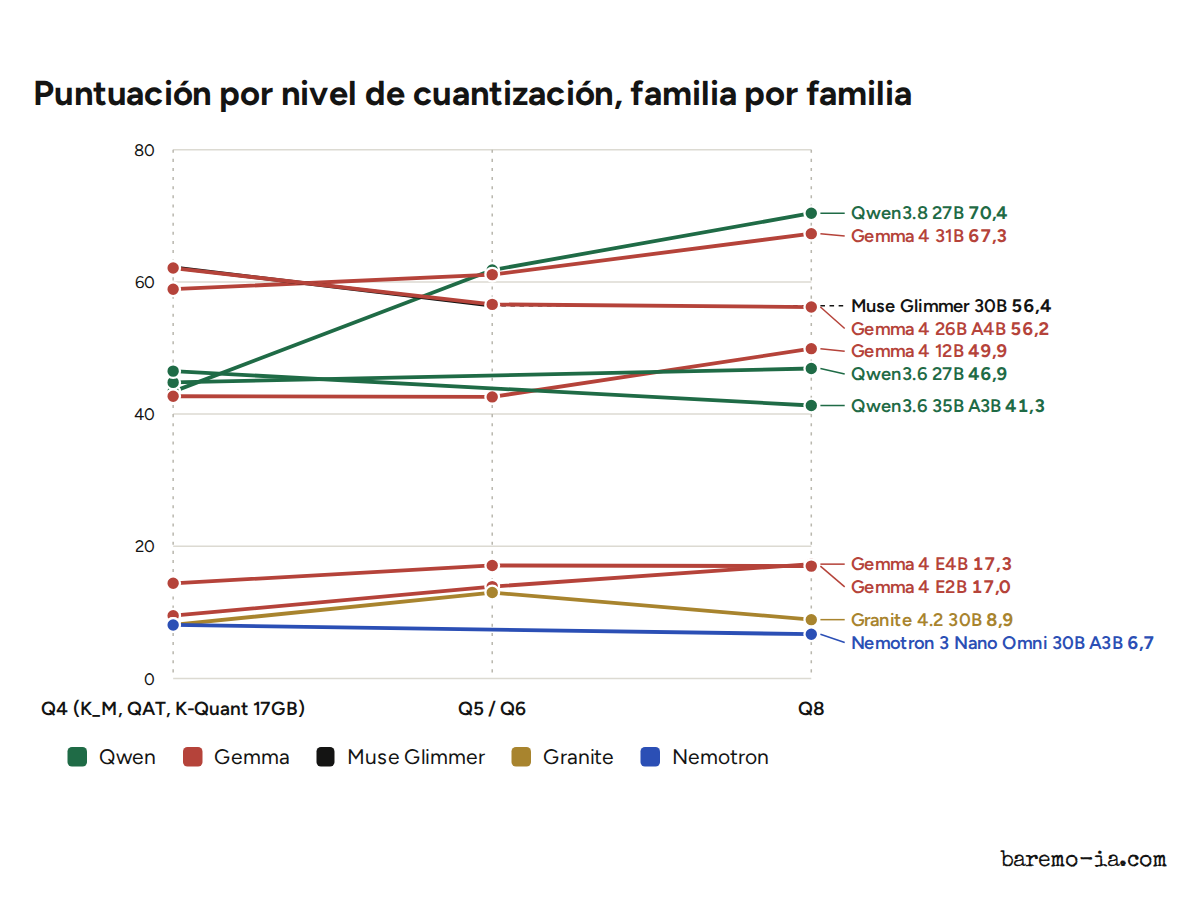 Q4, Q6 o Q8: la cuantización no cuesta nada en unos modelos y veintisiete puntos en otros
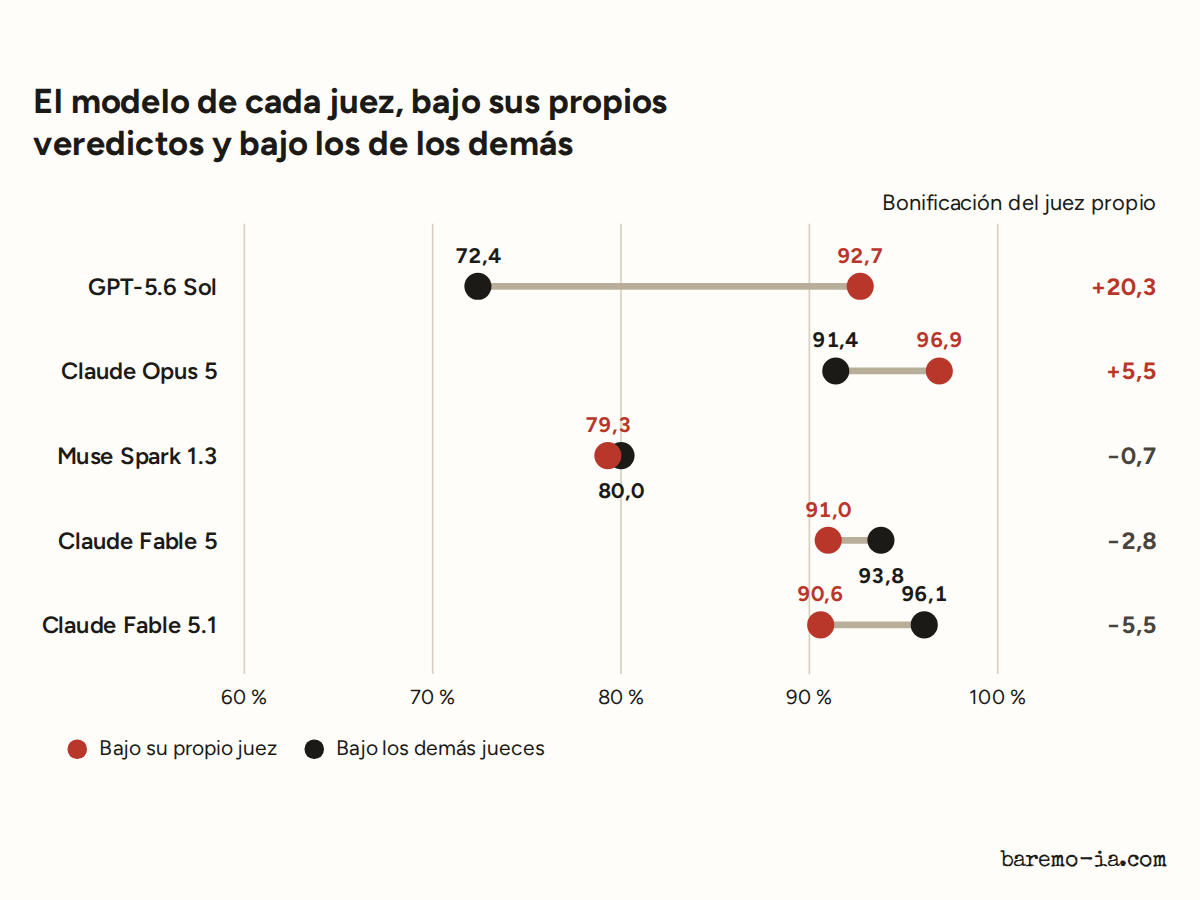 ¿Los jueces de IA favorecen a su propio modelo? Dos de cinco, hasta 20 puntos
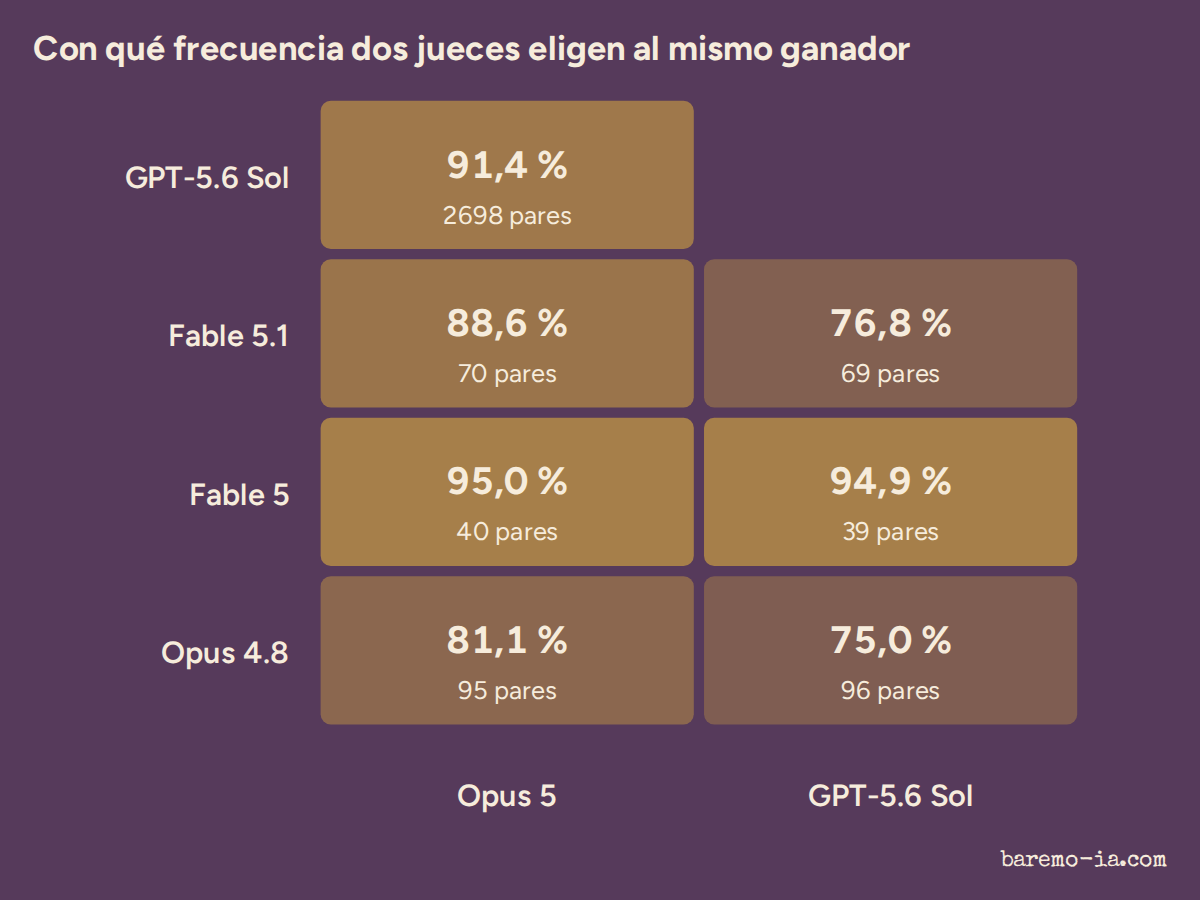 Los dos grandes jueces de IA eligen al mismo ganador nueve de cada diez veces. Las discrepancias están en otra parte
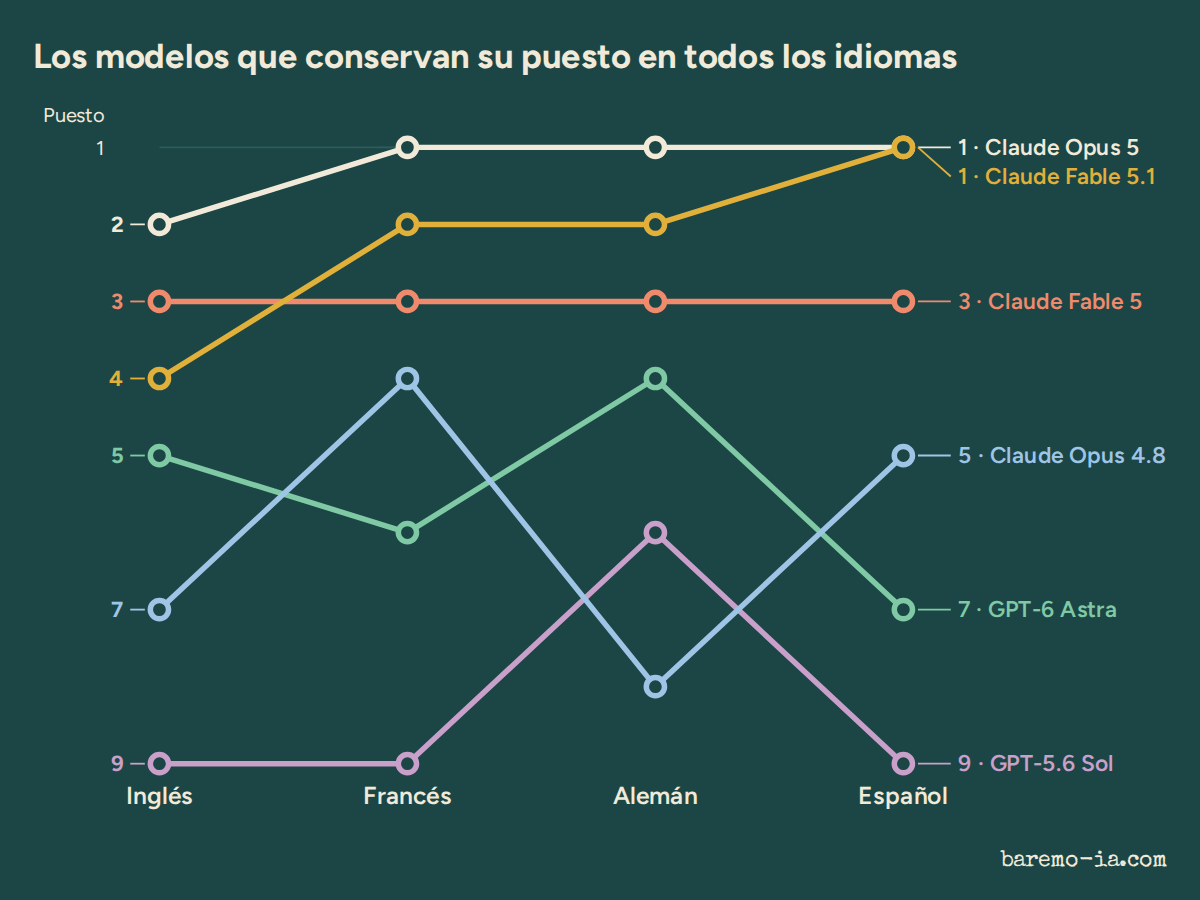 Un mismo modelo, cuatro idiomas: los seis primeros no se mueven, la zona media salta cuarenta puestos
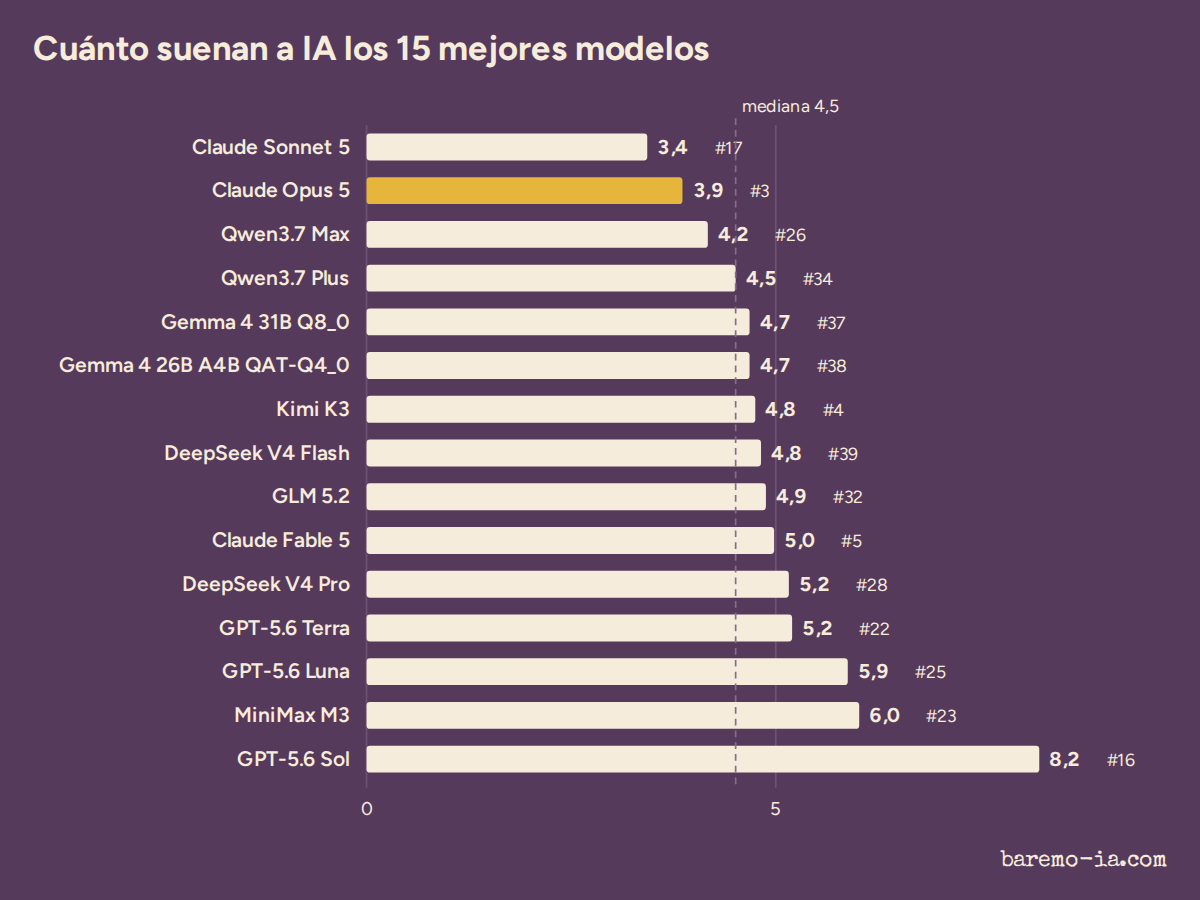 ¿Qué IA suena menos a IA? En español la raya es rara y «además» lo delata todo
Claude o ChatGPT, Claude o Gemini, Gemma o Qwen: los duelos más buscados tienen ya su página, con el veredicto de los duelos a ciegas. Cada modelo clasificado recibe además un índice de los tics de la prosa de máquina: frases hechas, rayas, enumeraciones de tres.
Ling 3.0 Flash. Hoy en el puesto 81 de 108, con una puntuación de 21,5. La mejor de sus 2 variantes clasificadas: Ling 3.0 Flash de InclusionAI (Q4_K_M, razonamiento high).
50.000
Alcanzado 57 días después del primer duelo, 20 días después del hito de 25.000.

DeepSeek V4.1 Flash. Hoy en el puesto 14 de 108, con una puntuación de 87,8. Son 28,3 puntos más que su predecesor, DeepSeek V4 Flash (puesto 41, 59,5).
GPT-6 Astra. Hoy en el puesto 8 de 108, con una puntuación de 94,6.
Claude Fable 5.1. Hoy en el puesto 2 de 108, con una puntuación de 98,1. Son 2,9 puntos más que su predecesor, Claude Fable 5 (puesto 6, 95,2).

Gemini 3.8 Flash. Hoy en el puesto 18 de 108, con una puntuación de 84,6. Son 1,1 puntos más que su predecesor, Gemini 3.6 Flash (puesto 21, 83,5).

Muse Spark 1.3. Hoy en el puesto 15 de 108, con una puntuación de 87,3. Son 4,1 puntos menos que su predecesor, Muse Spark 1.2 (puesto 12, 91,4).
Inkling. Hoy en el puesto 32 de 108, con una puntuación de 70,6.

Granite 4.2 8B. Hoy en el puesto 107 de 108, con una puntuación de 5,3. La mejor de sus 2 variantes clasificadas: Granite 4.2 8B de IBM (Q4_K_M, razonamiento full).

GLM 5.3 Flash. Hoy en el puesto 58 de 108, con una puntuación de 44,2.
Granite 4.2 30B. Hoy en el puesto 99 de 108, con una puntuación de 9,1. La mejor de sus 3 variantes clasificadas: Granite 4.2 30B de IBM (Q6_K, razonamiento full).

Hy4 Preview. Hoy en el puesto 37 de 108, con una puntuación de 62,3. Son 19,3 puntos más que su predecesor, Hy3 (puesto 60, 43,0). Duelos directos ganados contra él: 18 de 24 (75 %).

Qwen3.8 Flash. Hoy en el puesto 33 de 108, con una puntuación de 69,6.
25.000
Alcanzado 37 días después del primer duelo.
Gemini 3.7 Flash. Hoy en el puesto 40 de 108, con una puntuación de 59,6.
75
Con Seed 2.1 Turbo, 33 días después del primer duelo.
Aion 3.0. Hoy en el puesto 55 de 108, con una puntuación de 46,6.
GLM 5.3. Hoy en el puesto 9 de 108, con una puntuación de 94,0. Son 26,4 puntos más que su predecesor, GLM 5.2 (puesto 34, 67,6). Duelos directos ganados contra él: 18 de 23 (78 %).
Grok 4.6. Hoy en el puesto 31 de 108, con una puntuación de 71,5.
Hy3. Hoy en el puesto 60 de 108, con una puntuación de 43,0.
Mistral Medium 3.5. Hoy en el puesto 80 de 108, con una puntuación de 22,1.
Muse Spark 1.2. Hoy en el puesto 12 de 108, con una puntuación de 91,4.
Qwen3.8 Max. Hoy en el puesto 21 de 108, con una puntuación de 83,5. Son 8,8 puntos más que su predecesor, Qwen3.7 Max (puesto 28, 74,7).

Seed 2.1 Turbo. Hoy en el puesto 49 de 108, con una puntuación de 53,9.
Qwen3.8 27B. Hoy en el puesto 35 de 108, con una puntuación de 65,2. La mejor de sus 6 variantes clasificadas: Qwen3.8 27B de Alibaba (Q8_0, razonamiento xhigh). Son 22,3 puntos más que su predecesor, Qwen3.6 27B (puesto 61, 42,9).
50
Con Gemma 4 12B, 27 días después del primer duelo.
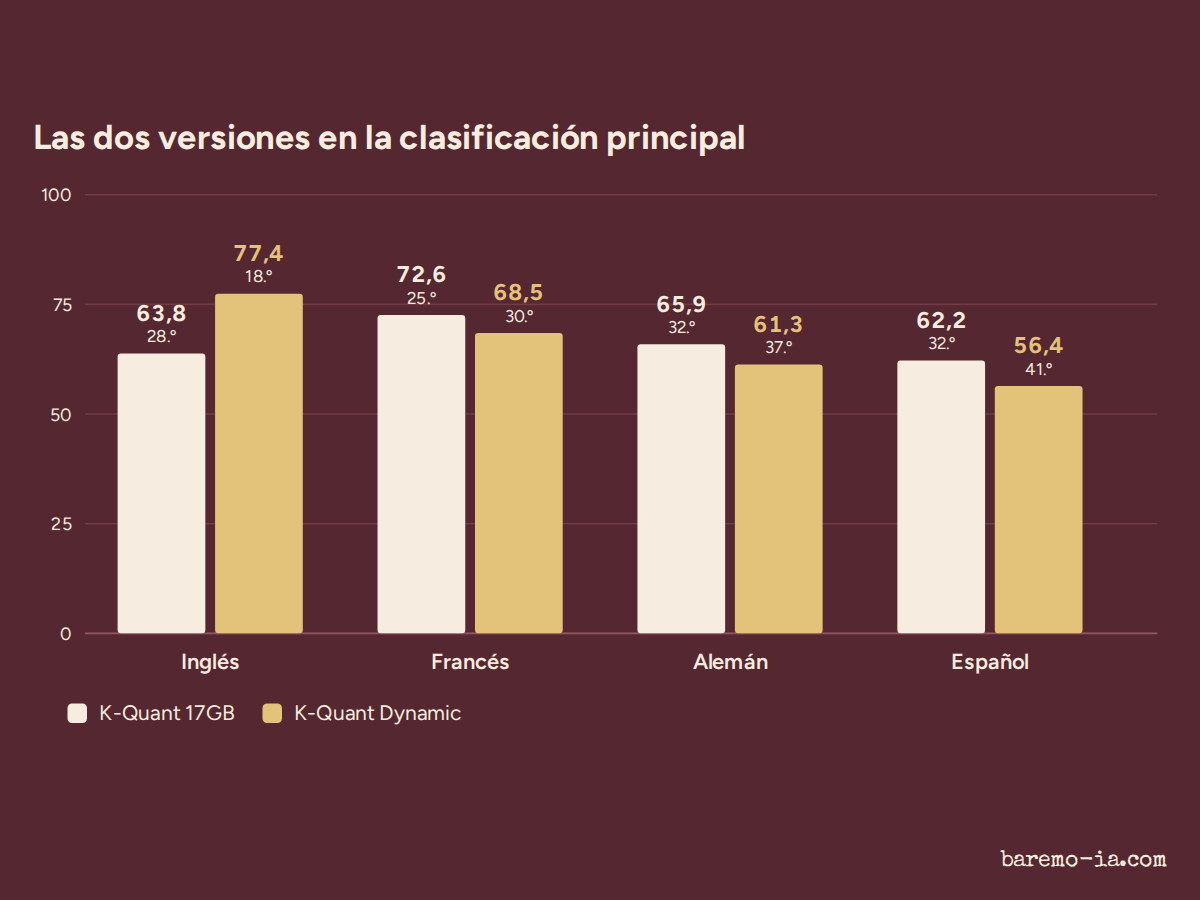
Muse Glimmer 30B. Hoy en el puesto 39 de 108, con una puntuación de 61,1. La mejor de sus 2 variantes clasificadas: Muse Glimmer 30B de Meta (K-Quant 17GB, razonamiento high).
Gemma 4 E2B. Hoy en el puesto 86 de 108, con una puntuación de 14,4. La mejor de sus 6 variantes clasificadas: Gemma 4 E2B de Google (Q8_0, razonamiento activado).
Gemma 4 E4B. Hoy en el puesto 85 de 108, con una puntuación de 14,8. La mejor de sus 6 variantes clasificadas: Gemma 4 E4B de Google (Q8_0, razonamiento activado).
Nemotron 3 Super 120B A12B. Hoy en el puesto 79 de 108, con una puntuación de 23,4.

Laguna S 2.1 UD. Hoy en el puesto 104 de 108, con una puntuación de 7,1.
Nemotron 3 Nano Omni 30B A3B. Hoy en el puesto 103 de 108, con una puntuación de 7,2. La mejor de sus 2 variantes clasificadas: Nemotron 3 Nano Omni 30B A3B de NVIDIA (Q4_K_M, razonamiento activado).
Claude Sonnet 5. Hoy en el puesto 19 de 108, con una puntuación de 84,4.
Gemini 3.6 Flash. Hoy en el puesto 21 de 108, con una puntuación de 83,5.
Claude Opus 5. Hoy en el puesto 3 de 108, con una puntuación de 97,8. Son 3,0 puntos más que su predecesor, Claude Opus 4.8 (puesto 7, 94,8).
GPT-5.6 Luna. Hoy en el puesto 27 de 108, con una puntuación de 77,2.
Kimi K3. Hoy en el puesto 4 de 108, con una puntuación de 96,4.
25
Con Claude Fable 5, 6 días después del primer duelo.
Claude Fable 5. Hoy en el puesto 6 de 108, con una puntuación de 95,2.
GPT-5.6 Sol. Hoy en el puesto 16 de 108, con una puntuación de 85,2.
Claude Opus 4.8. Hoy en el puesto 7 de 108, con una puntuación de 94,8.
GPT-5.6 Terra. Hoy en el puesto 23 de 108, con una puntuación de 82,6.
Mistral Medium 3.5 128B. Hoy en el puesto 75 de 108, con una puntuación de 32,9.
Gemma 4 12B. Hoy en el puesto 56 de 108, con una puntuación de 45,8. La mejor de sus 6 variantes clasificadas: Gemma 4 12B de Google (Q8_0, razonamiento activado).
MiniMax M3. Hoy en el puesto 26 de 108, con una puntuación de 79,8.
DeepSeek V4 Pro. Hoy en el puesto 29 de 108, con una puntuación de 73,3. La mejor de sus 2 variantes clasificadas: DeepSeek V4 Pro de DeepSeek (razonamiento activado).
Gemma 4 26B A4B. Hoy en el puesto 42 de 108, con una puntuación de 59,2. La mejor de sus 6 variantes clasificadas: Gemma 4 26B A4B de Google (QAT-Q4_0, razonamiento activado).
Gemma 4 31B. Hoy en el puesto 38 de 108, con una puntuación de 61,6. La mejor de sus 6 variantes clasificadas: Gemma 4 31B de Google (Q8_0, razonamiento activado).
GLM 5.2. Hoy en el puesto 34 de 108, con una puntuación de 67,6.
MiMo V2.5 Pro. Hoy en el puesto 62 de 108, con una puntuación de 42,3. La mejor de sus 2 variantes clasificadas: MiMo V2.5 Pro de Xiaomi (razonamiento activado).
Qwen3.6 27B. Hoy en el puesto 61 de 108, con una puntuación de 42,9. La mejor de sus 3 variantes clasificadas: Qwen3.6 27B de Alibaba (Q8_0, razonamiento activado).
Qwen3.6 35B A3B. Hoy en el puesto 57 de 108, con una puntuación de 44,3. La mejor de sus 4 variantes clasificadas: Qwen3.6 35B A3B de Alibaba (Q4_K_M, razonamiento activado).
Qwen3.7 Max. Hoy en el puesto 28 de 108, con una puntuación de 74,7. La mejor de sus 2 variantes clasificadas: Qwen3.7 Max de Alibaba (razonamiento activado).
Todos los modelos clasificados por su escritura en español, con filtros por tipo de texto, empresa, tamaño, razonamiento y cuantización, y las matrices de duelos.
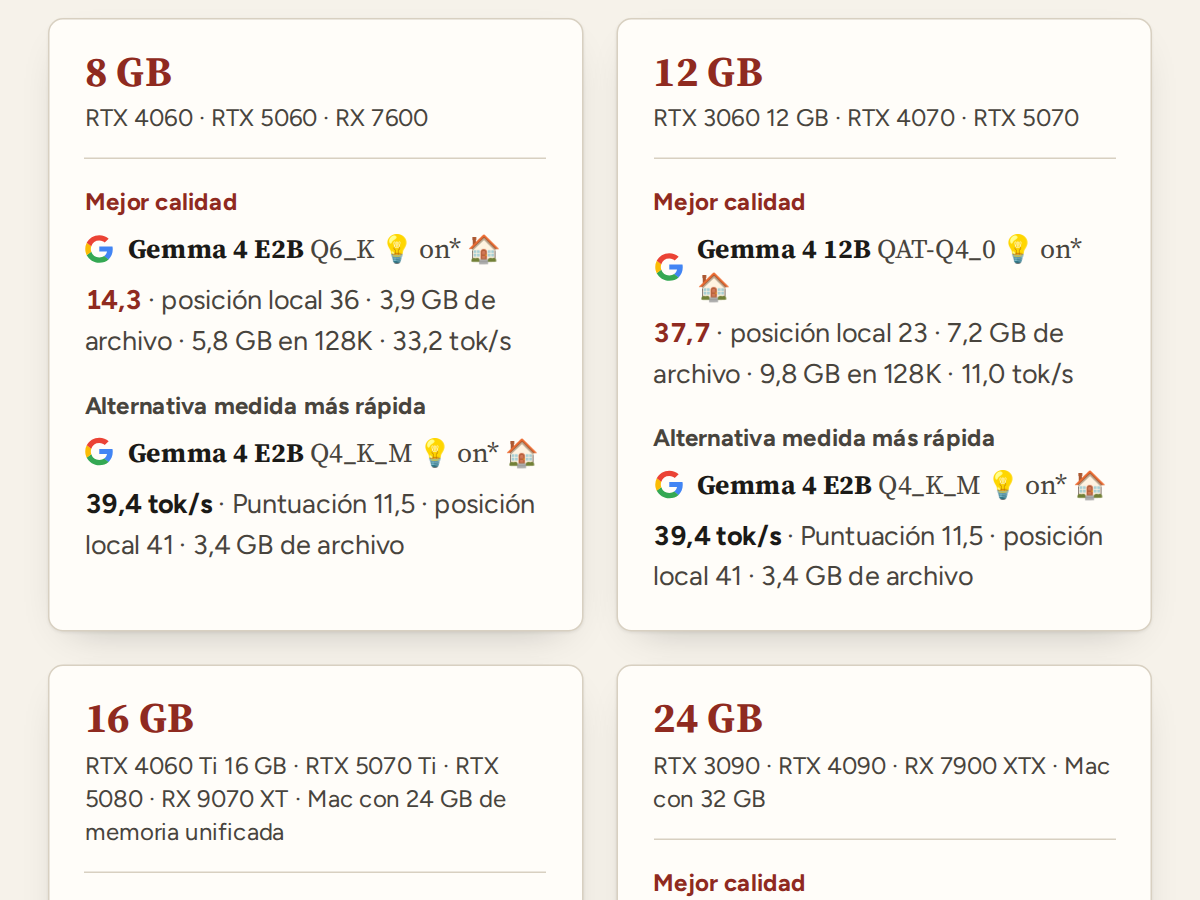
La clasificación viva de los modelos de pesos abiertos para escribir en español, la memoria que necesita cada archivo y lo que cabe en 16, 24, 32 o 128 GB.
Artículos basados en datos sobre los jueces, la cuantización, el razonamiento y los cuatro idiomas.