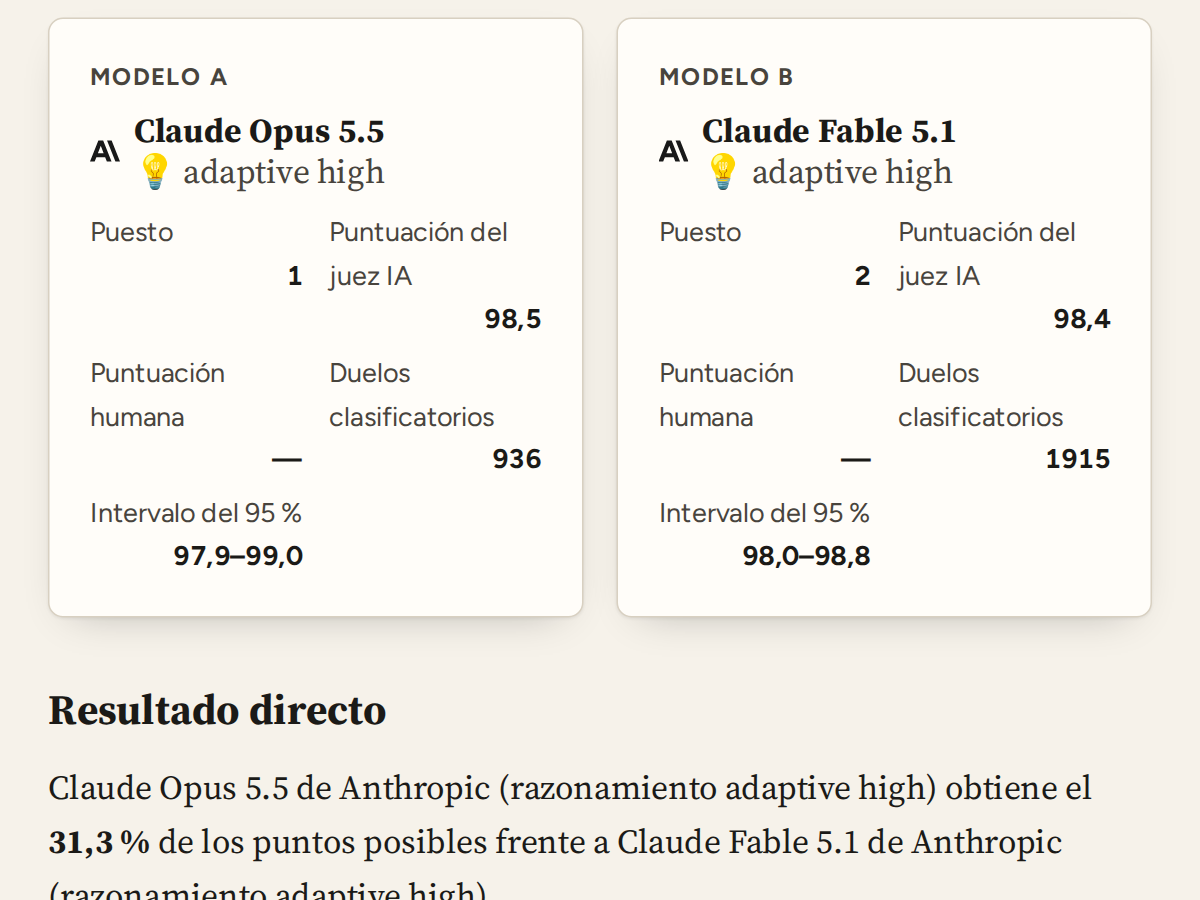
Claude Opus 5.5 de Anthropic (razonamiento adaptive high) es hoy el modelo que mejor escribe en español, con una puntuación de 98,5. Entre los modelos que se pueden ejecutar en tu propio equipo, Qwen3.8 27B de Alibaba (Q8_0, razonamiento xhigh) va en cabeza con 65,2.
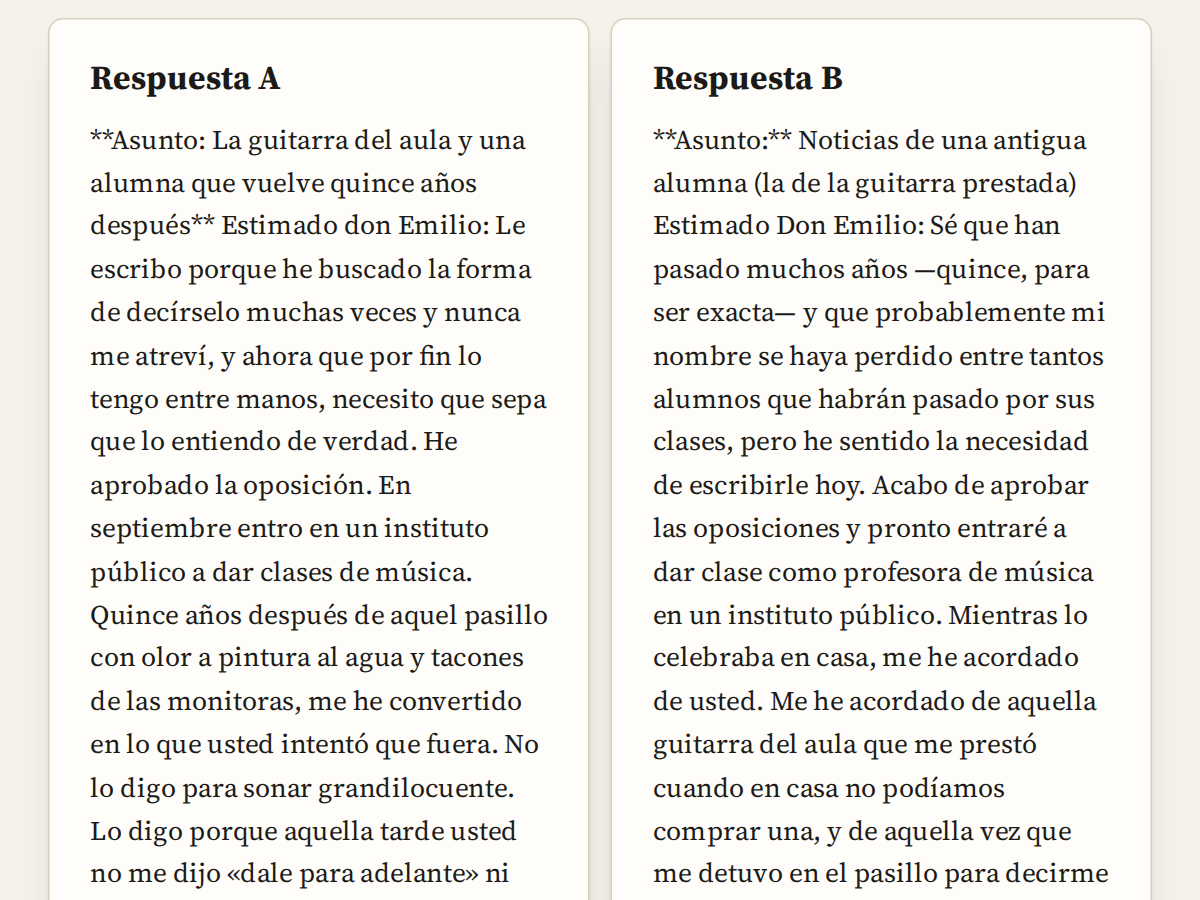
Baremo IA mide la calidad de escritura de los principales modelos de IA a partir de un corpus de consignas concebido directamente en español. Las respuestas a una misma consigna se comparan a ciegas, sin mostrar el nombre de los modelos, y los veredictos se agregan en una clasificación específica para el español.
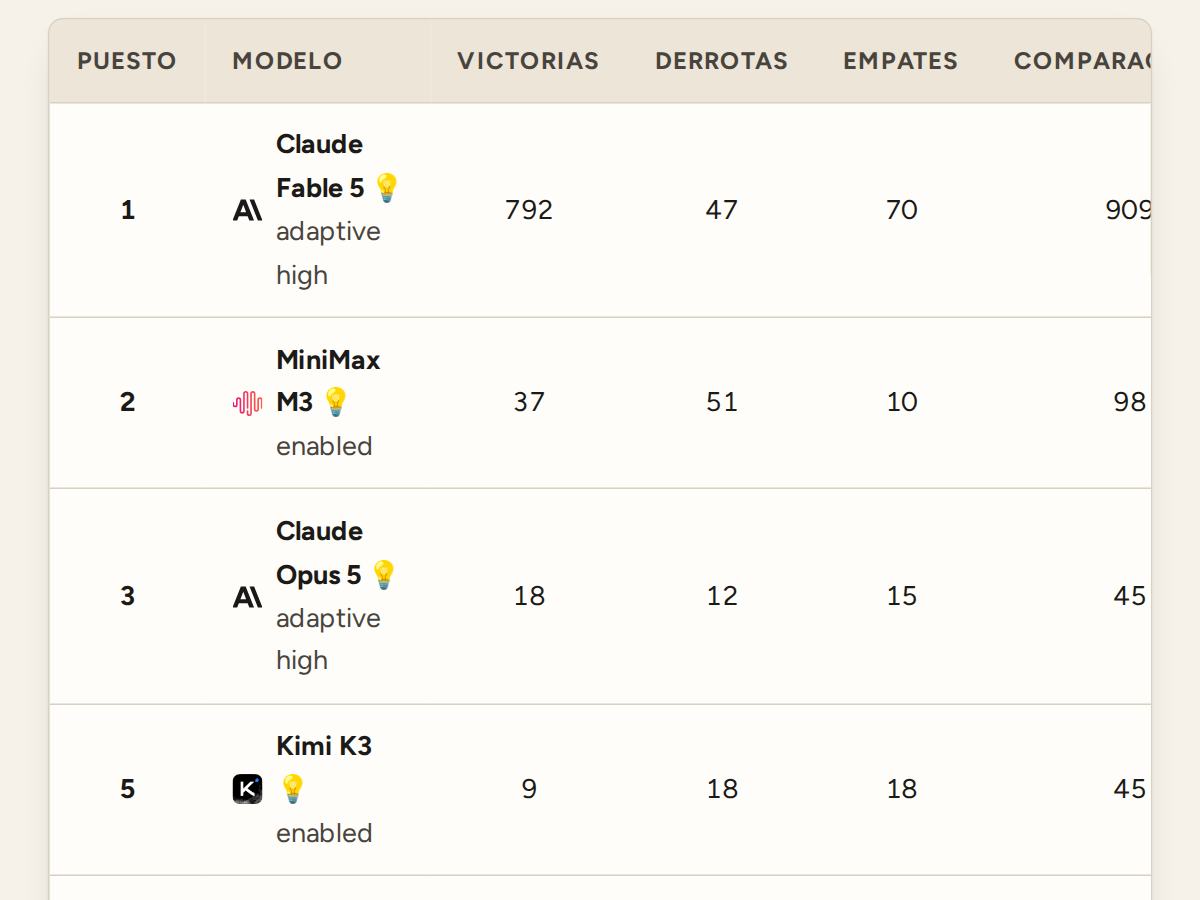
108 modelos comparados en 106.327 veredictos a ciegas, datos del 19 de octubre de 2026.
Los 10 mejores modelos
Los diez mejores modelos para escribir en español
#
Modelo
Puntuación
1
Claude Opus 5.5 💡 adaptive high
98,5
2
Claude Fable 5.1 💡 adaptive high
98,1
3
Claude Opus 5 💡 adaptive high
97,8
4
Kimi K3 💡 enabled
96,4
5
GPT-6.1 Sol 💡 high
95,7
6
Claude Fable 5 💡 adaptive high
95,2
7
Claude Opus 4.8 💡 adaptive high
94,8
8
GPT-6 Astra 💡 high
94,6
9
GLM 5.3 💡 max
94,0
10
Claude Sonnet 5.5 💡 adaptive high
93,7
Esta puntuación no es una nota porcentual: 50 equivale a una probabilidad estimada de una entre dos de superar al modelo medio en español.
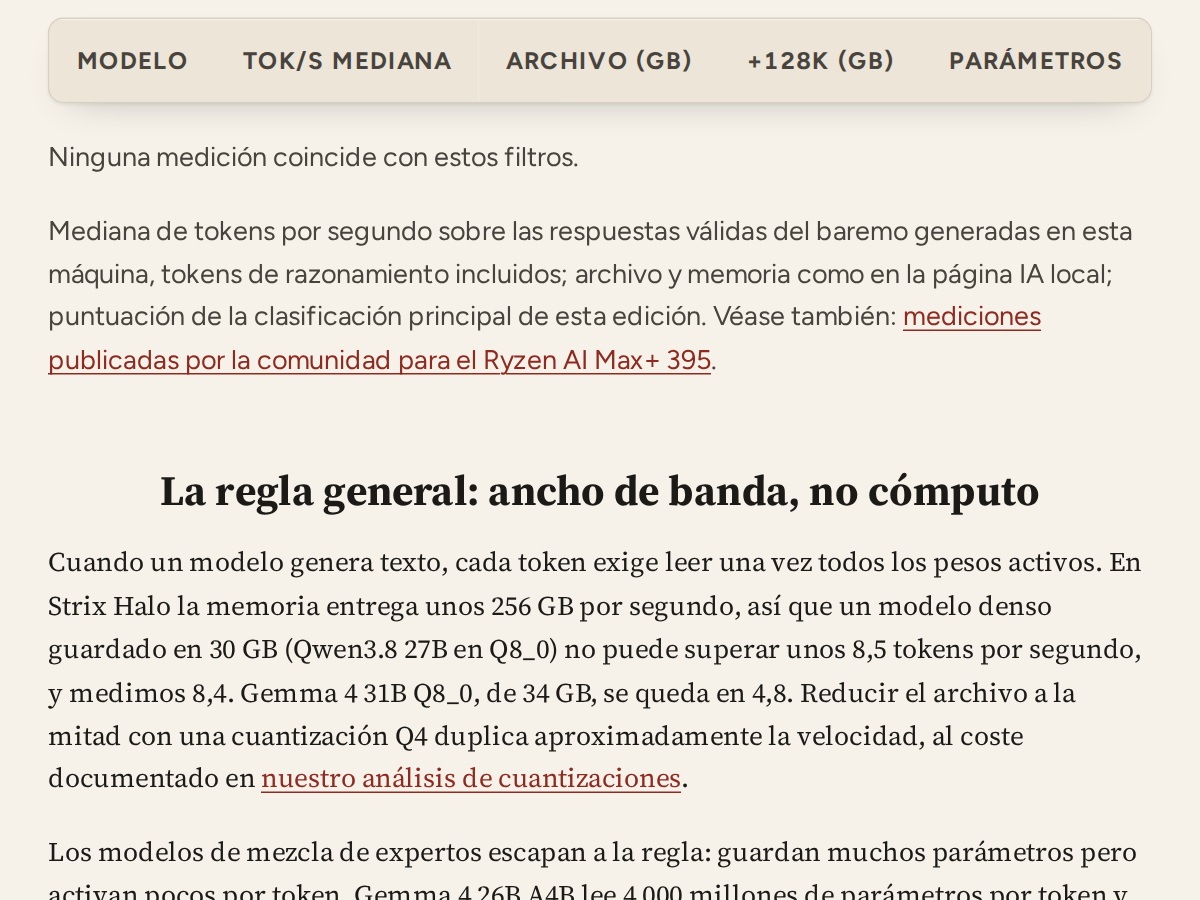
Tamaño del archivo GGUF probado (GB decimales, como en LM Studio) · +128K: Archivo + caché de contexto a 131 072 tokens (128K), caché F16, Flash Attention activada (GB) · +256K: Lo mismo a 262 144 tokens (256K), limitado a la ventana de contexto nativa (GB)
El mejor modelo local según tu memoria
La versión que mejor escribe entre las que caben en la memoria de la tarjeta gráfica o la memoria unificada, con contexto corto. Detalles, velocidades y alternativas en la página IA local.
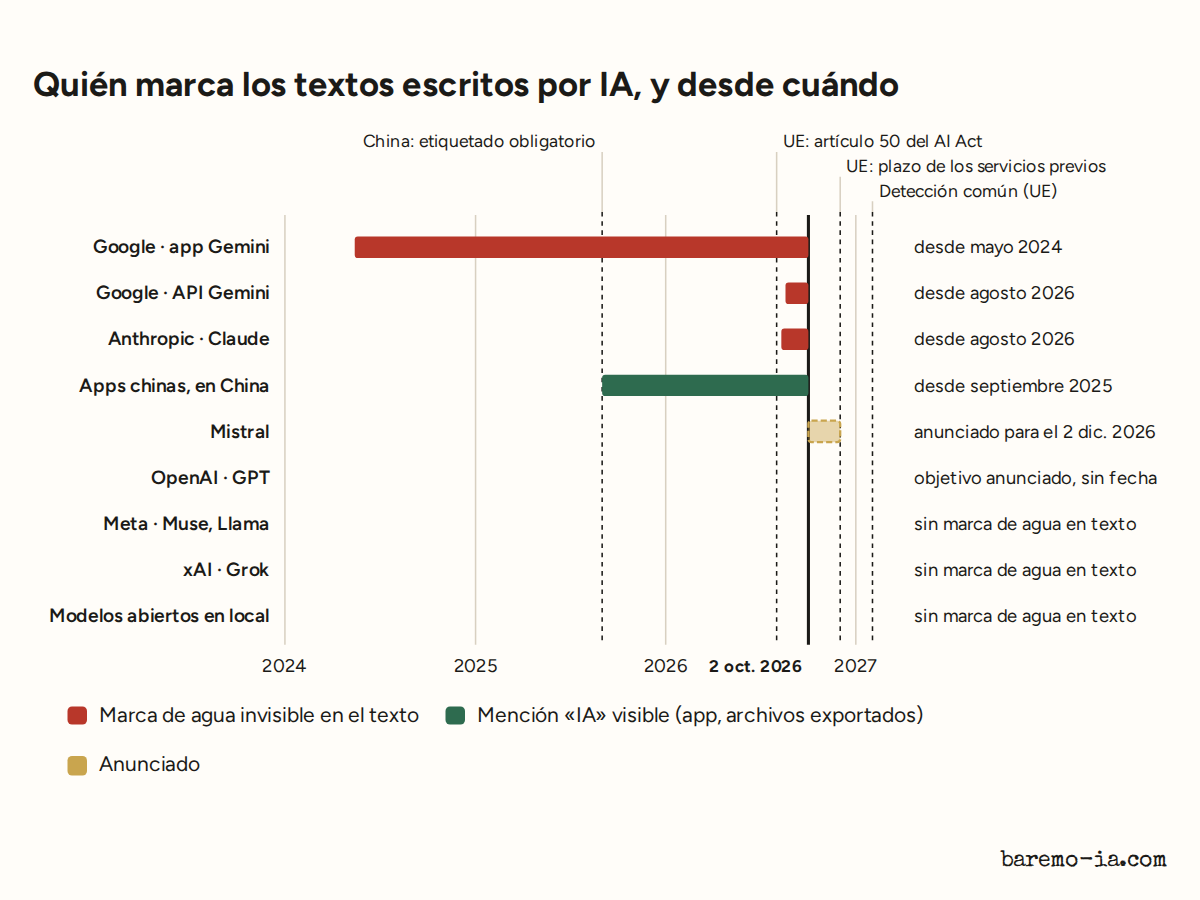
Desde este verano, los textos de Claude y Gemini llevan una marca invisible. Los de ChatGPT, Grok, Mistral, Meta AI y los modelos que se ejecutan en casa no llevan ninguna, y los servicios chinos se conforman con una mención visible. Pero hoy nadie, fuera de las empresas implicadas, puede comprobar un texto.
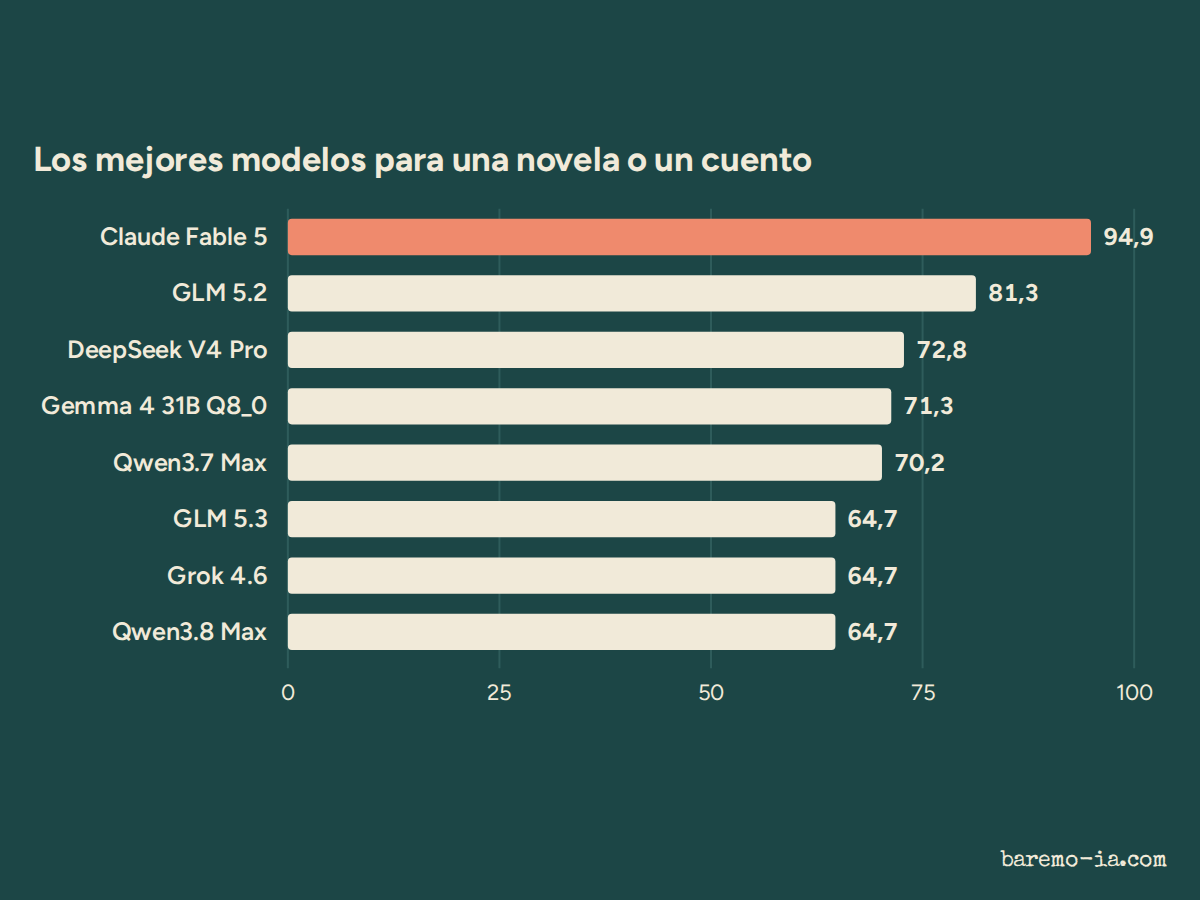
La clasificación tiene un ganador; tus textos tienen varios. Solo con los duelos de un tipo de texto, a 20 de septiembre de 2026, Claude Fable 5 gana la ficción, Claude Opus 5 los correos personales, Claude Fable 5.1 las cartas de presentación y Kimi K3 las explicaciones. Una guía sencilla, tarea por tarea, con el mejor archivo para tu propio ordenador.
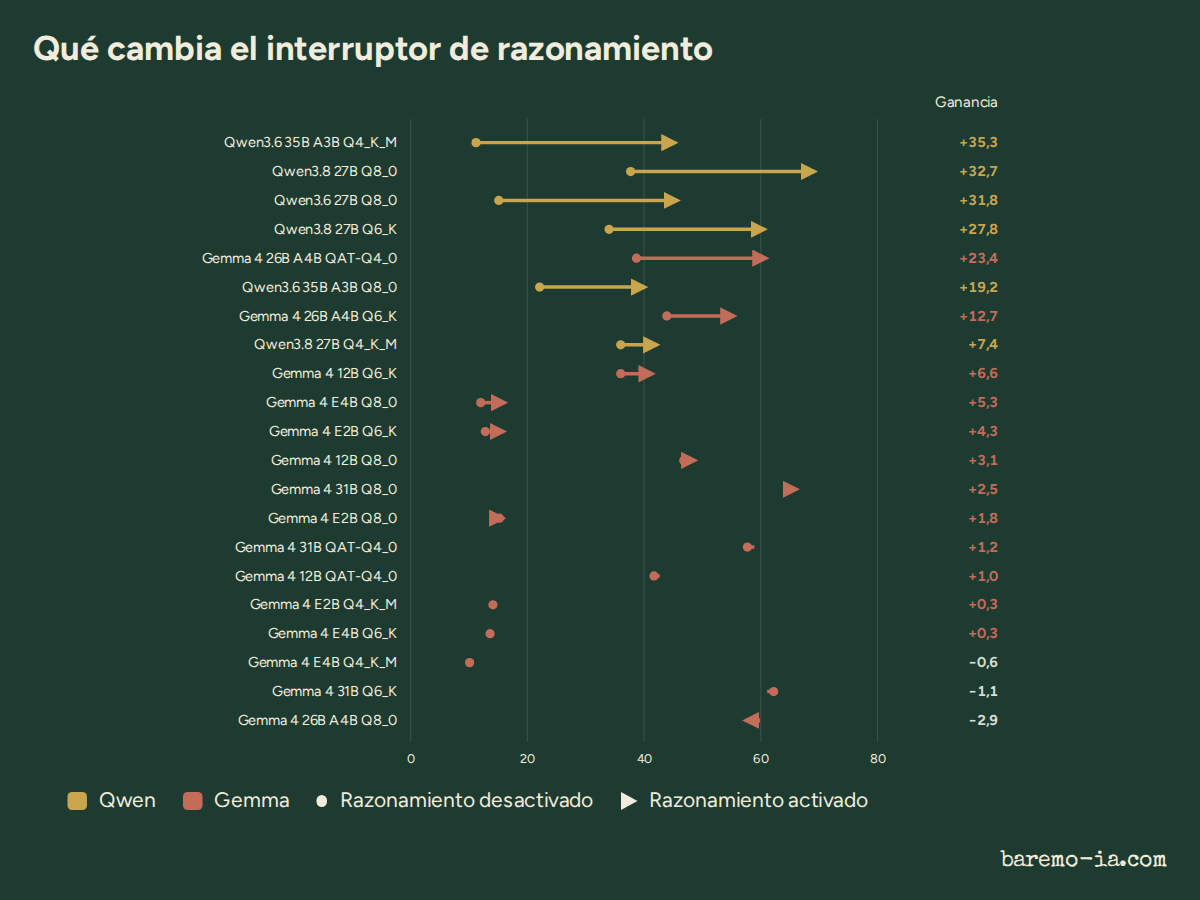
El mismo archivo, las mismas consignas, un solo interruptor. En 21 versiones locales, activar el razonamiento aporta de media 26 puntos a la familia Qwen y 5 a los Gemma 4 de 12B en adelante; los pequeños Gemma E2B y E4B ganan menos de dos. Qwen3.6 35B A3B Q4_K_M gana 35 puntos, más que ningún otro modelo en español.
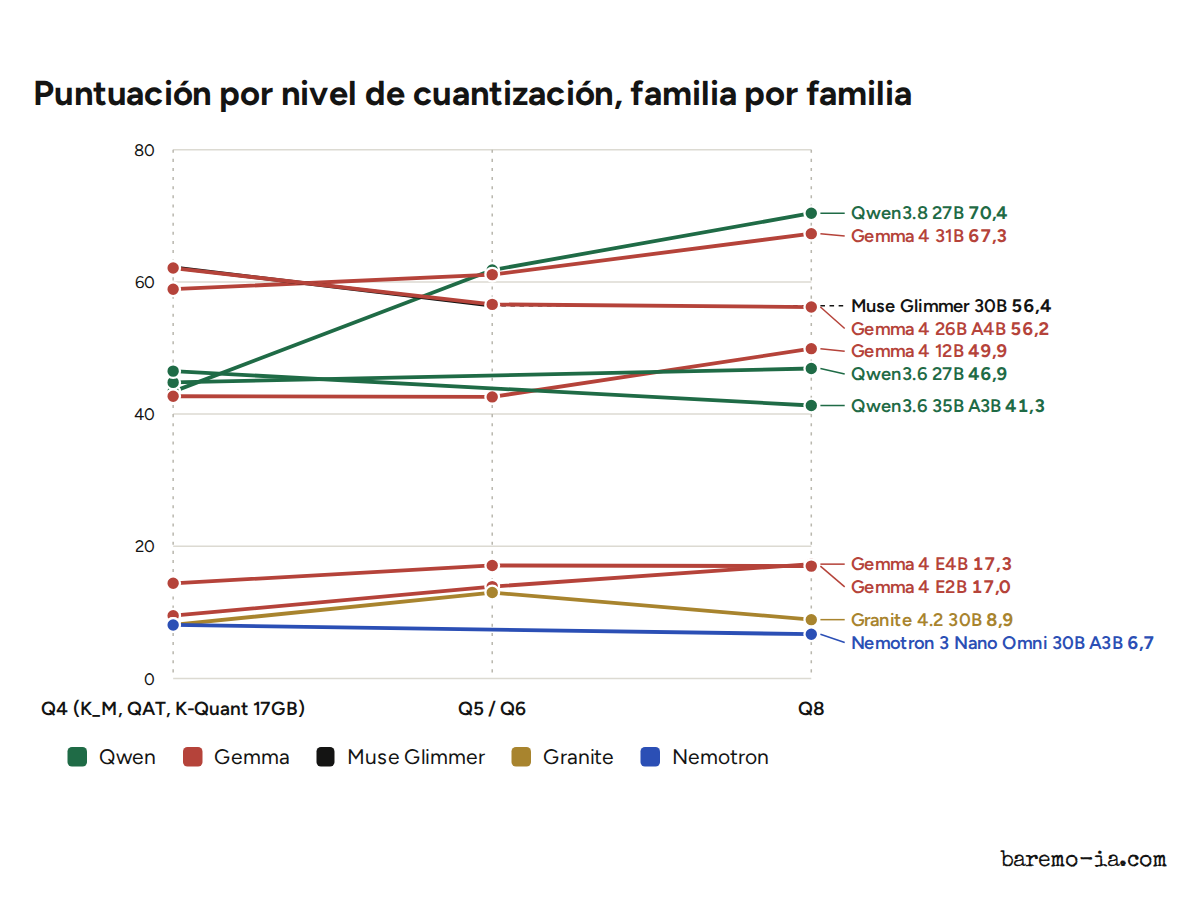
El mismo modelo, tres archivos, tres puntuaciones. En español, Qwen3.8 27B pierde 27 puntos entre Q8_0 y Q4_K_M, la mayor caída de las cuatro ediciones, mientras que Gemma 4 26B A4B escribe mejor en su archivo QAT de 4 bits que en Q8 y Qwen3.6 27B apenas nota la diferencia. No hay regla general, solo mediciones.
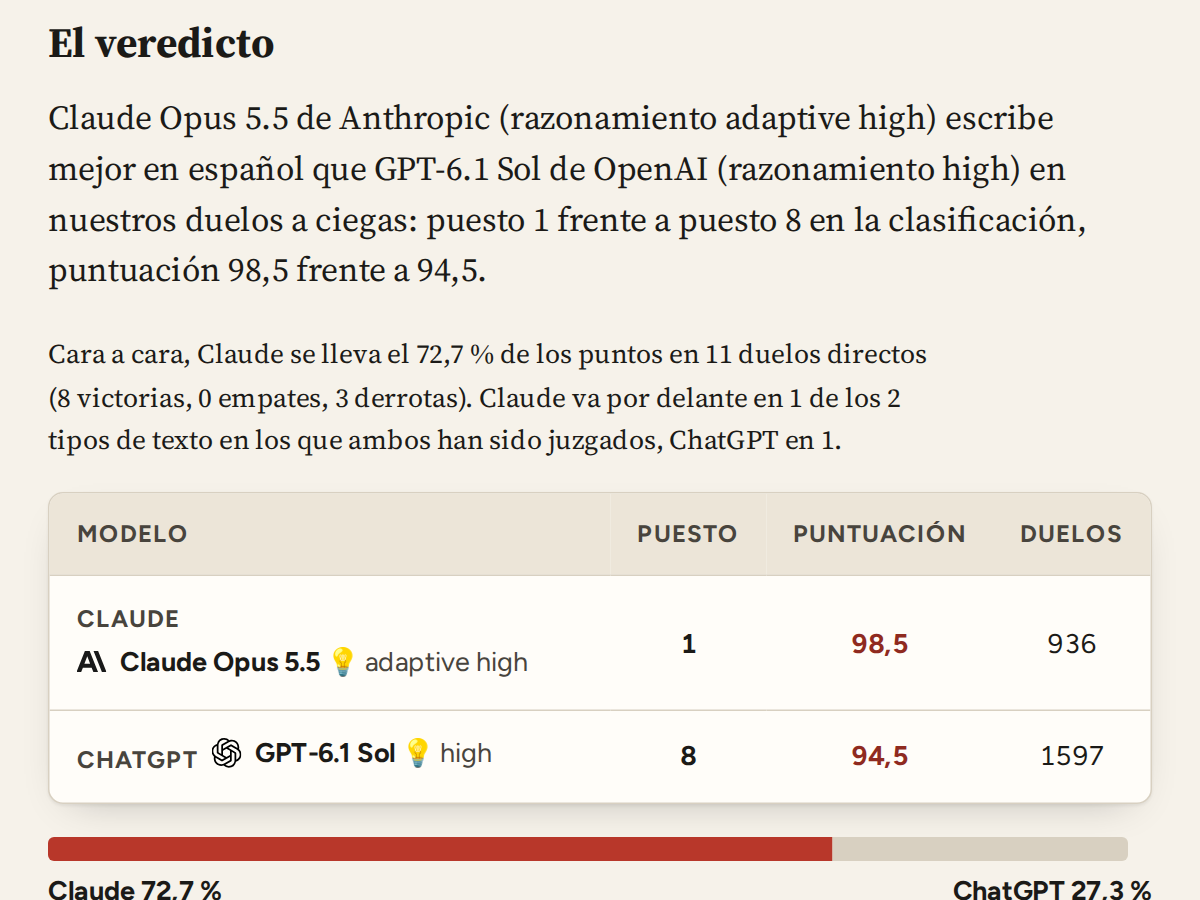
Los dos asistentes por los que más se pregunta, juzgados con las mismas consignas en español en duelos a ciegas: cuál escribe mejor, por cuánto y en qué tipos de texto. Se actualiza con cada exportación de la clasificación.
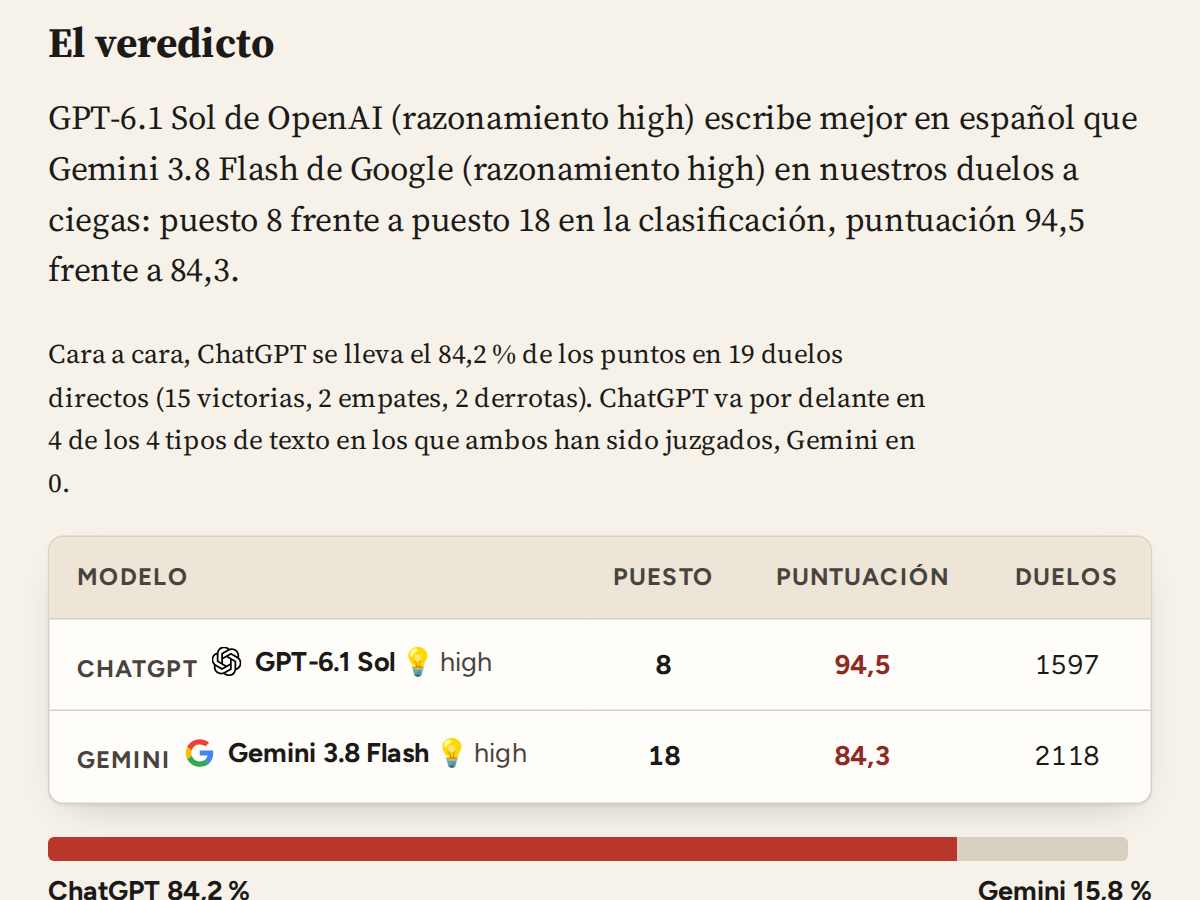
El mejor modelo de OpenAI contra el mejor de Google, con las mismas consignas en español, en duelos a ciegas: quién va delante en la clasificación, cómo fueron los duelos directos y dónde es más fuerte cada uno.
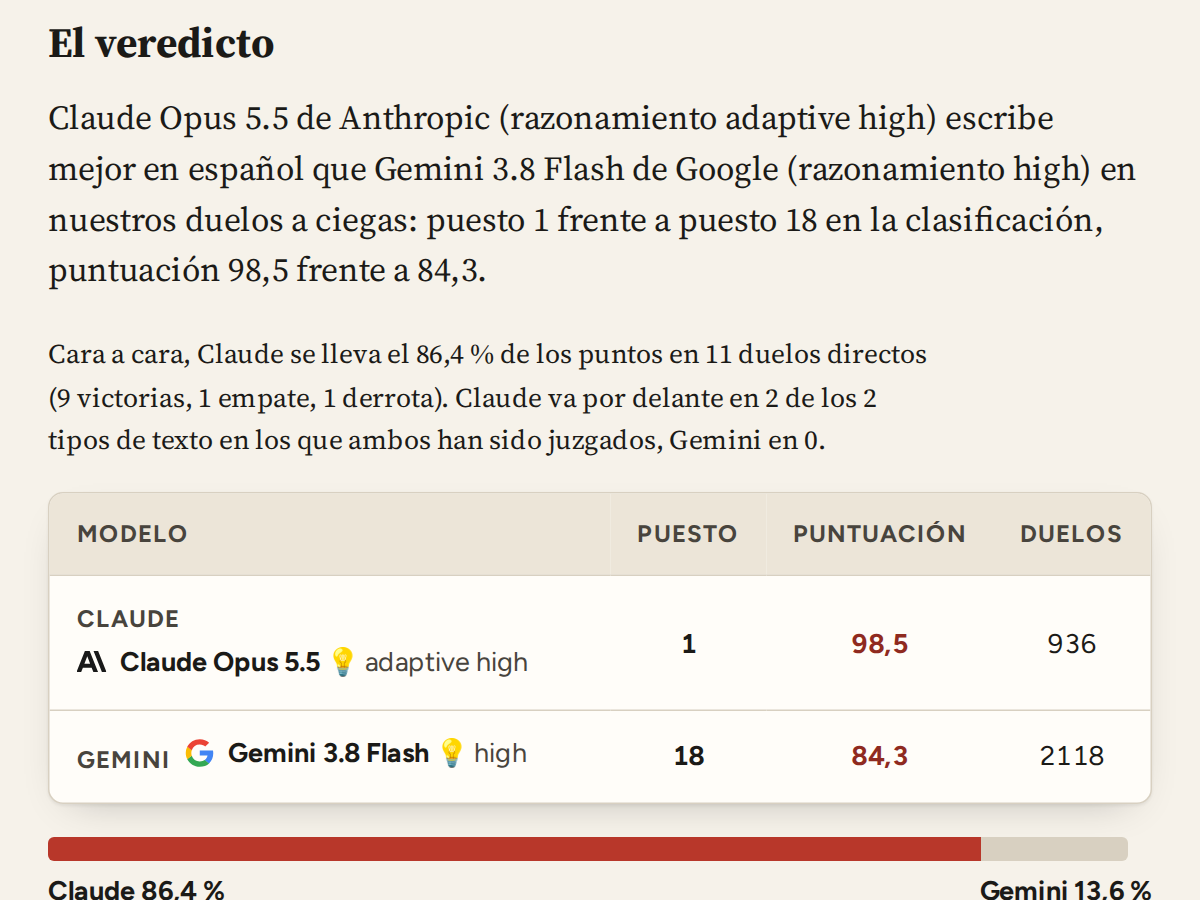
El mejor modelo de Anthropic contra el mejor de Google, con las mismas consignas en español, en duelos a ciegas: la distancia en la clasificación, el balance directo y los tipos de texto en los que Gemini se acerca más.
Quién mantiene este baremo, en qué máquinas y los principios detrás de los duelos a ciegas.
La clasificación evalúa únicamente la calidad de escritura. Las consignas se conciben en el idioma evaluado y los nombres de los modelos permanecen ocultos hasta el veredicto, para que su reputación no influya en la evaluación. Este sitio es un proyecto personal. Ningún proveedor de modelos me paga y no tengo ningún interés en favorecer a uno.