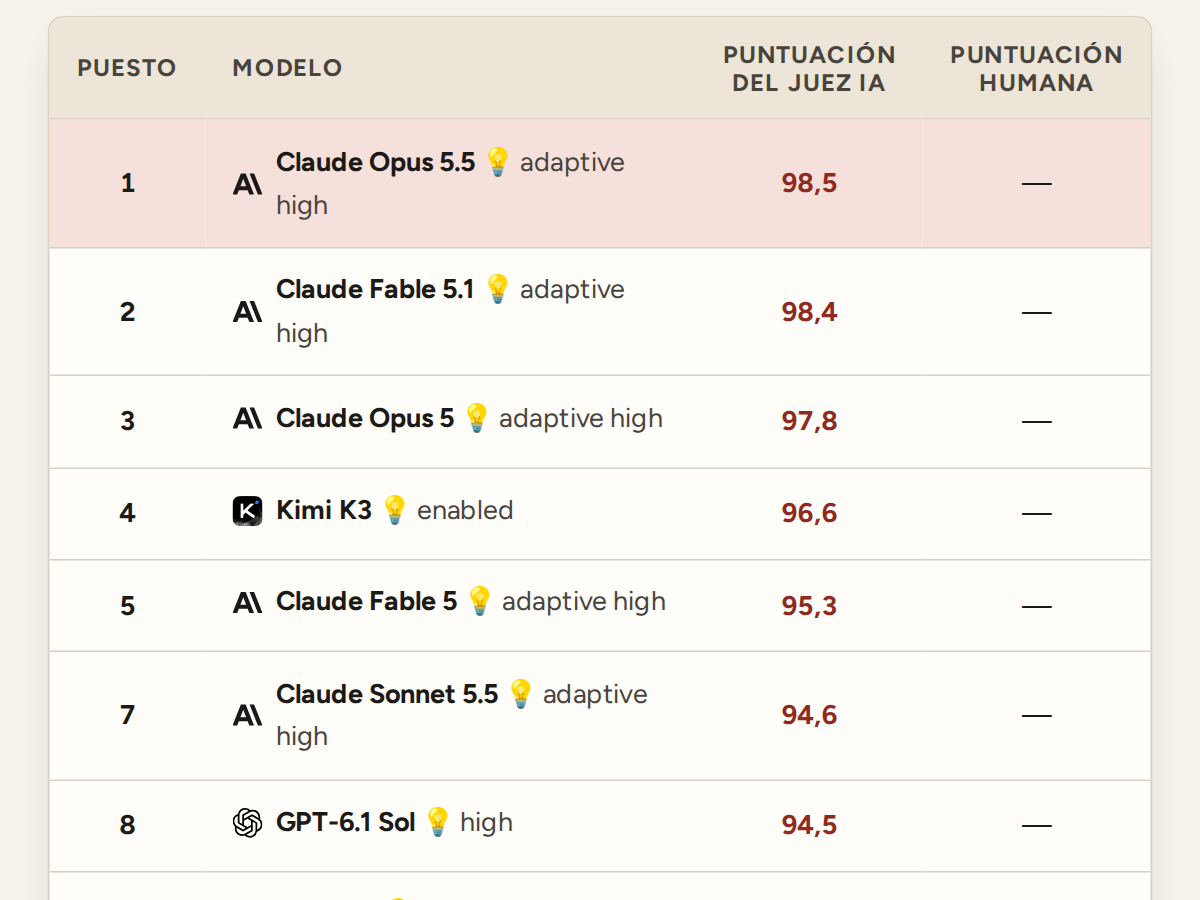
Me llamo Johannes Eva y creo sitios web desde hace 27 años. Baremo IA nació para cubrir una carencia: ninguna clasificación medía lo que me interesaba, la calidad de escritura de los modelos de IA en español.
Los benchmarks públicos se centran en el código, las matemáticas y el razonamiento. La pequeña parte que dedican a la escritura casi siempre se evalúa en inglés. Aquí solo importa la calidad de los textos generados. Las consignas se conciben directamente en español y las respuestas se comparan a ciegas.
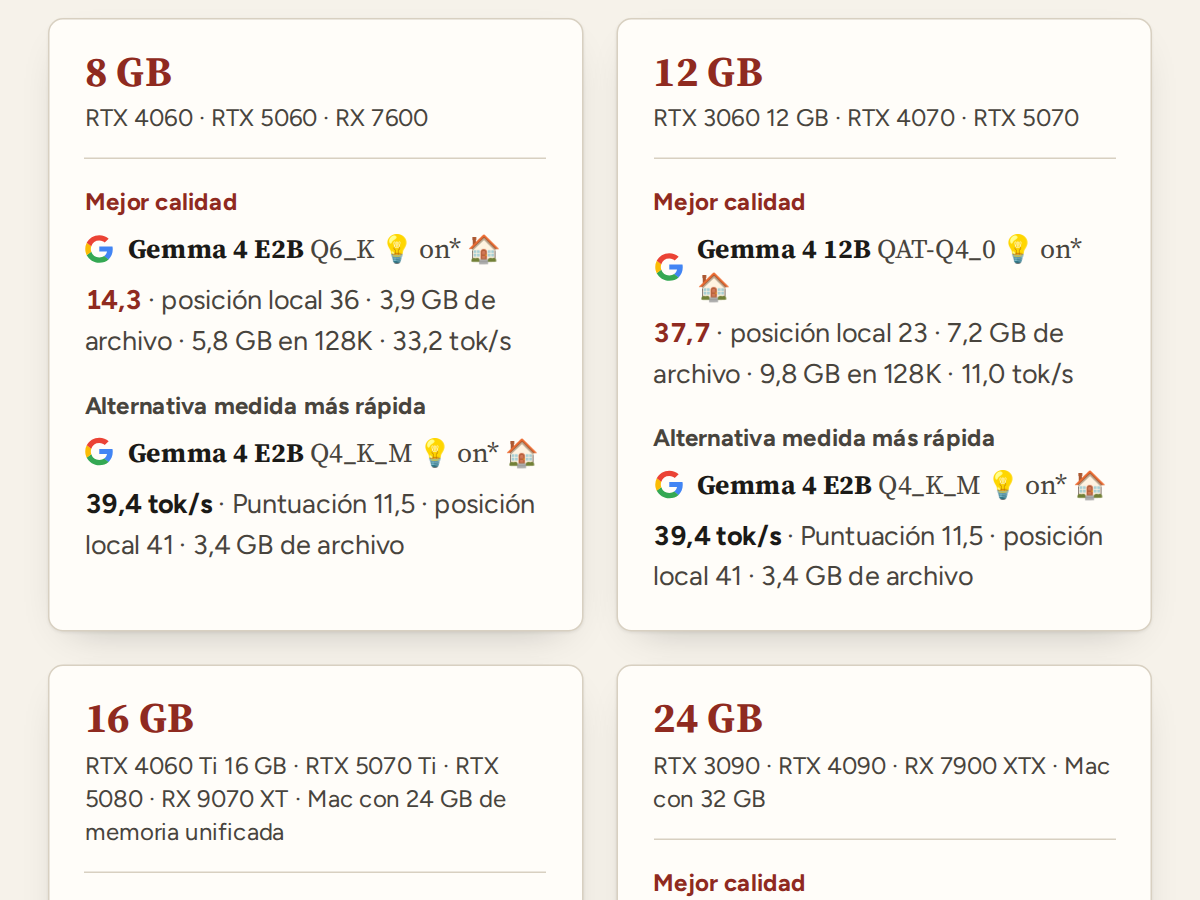
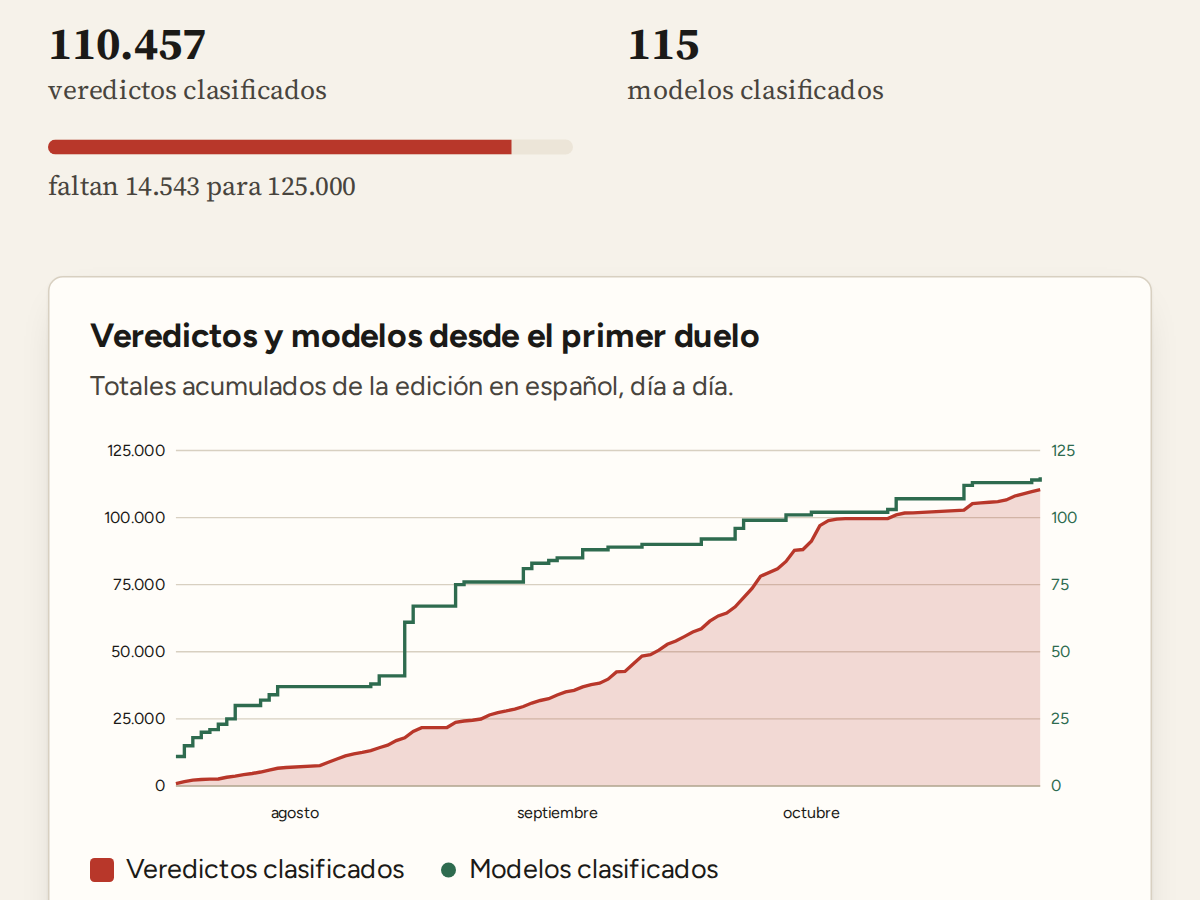
Los modelos que pueden ejecutarse en casa ocupan un lugar especial. Gemma 4, Qwen 3.6 y 3.8, Ling 3.0 Flash, Muse Glimmer y Granite 4.2 son algunas de las familias marcadas con 🏠. Se han ejecutado localmente con varias cuantizaciones, con el razonamiento activado y desactivado. La generación local está suspendida desde el 22 de septiembre de 2026; las respuestas ya generadas se siguen juzgando.
Este sitio es un proyecto personal. Ningún proveedor de modelos me paga y no tengo ningún interés en favorecer a uno.
Los equipos utilizados para los modelos locales
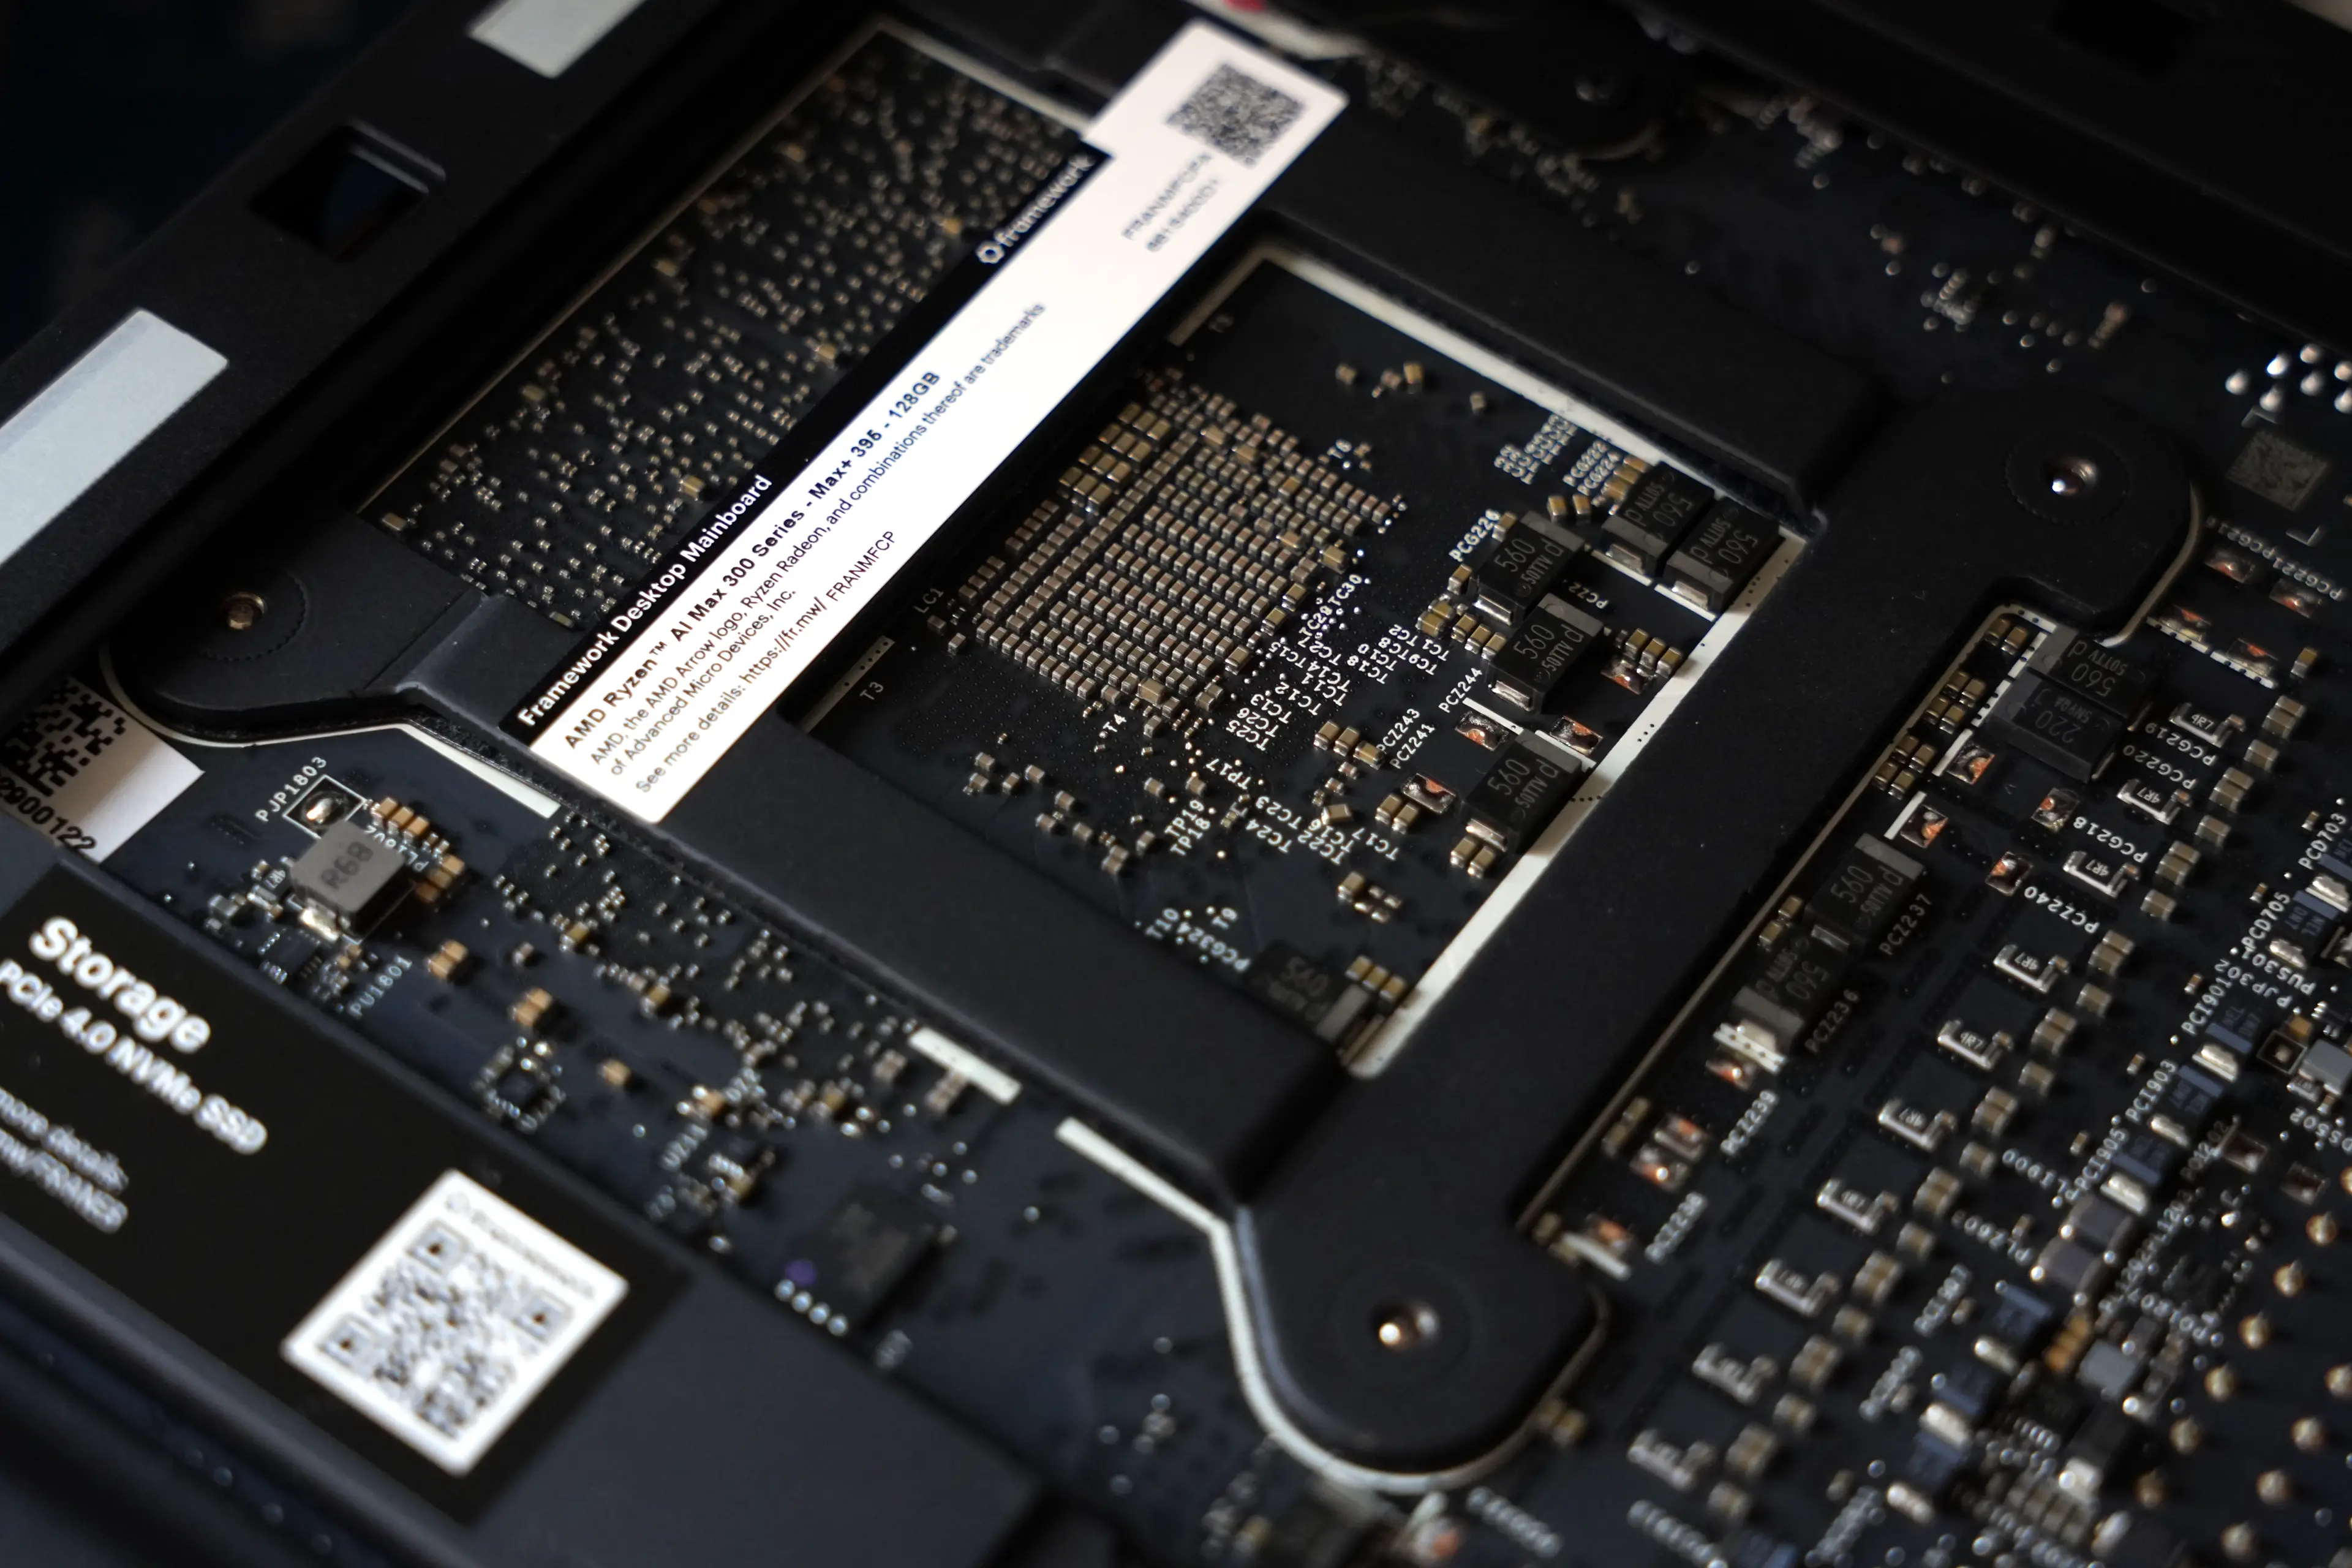
- Ordenador
- Framework Desktop, AMD Ryzen AI Max serie 300, revisión A6
- Procesador
- AMD Ryzen AI Max+ 395, 16 núcleos y 32 hilos, hasta 5,19 GHz
- Gráficos
- AMD Radeon 8060S integrada
- Memoria
- 128 GB de memoria unificada, compartida por el procesador y la unidad gráfica
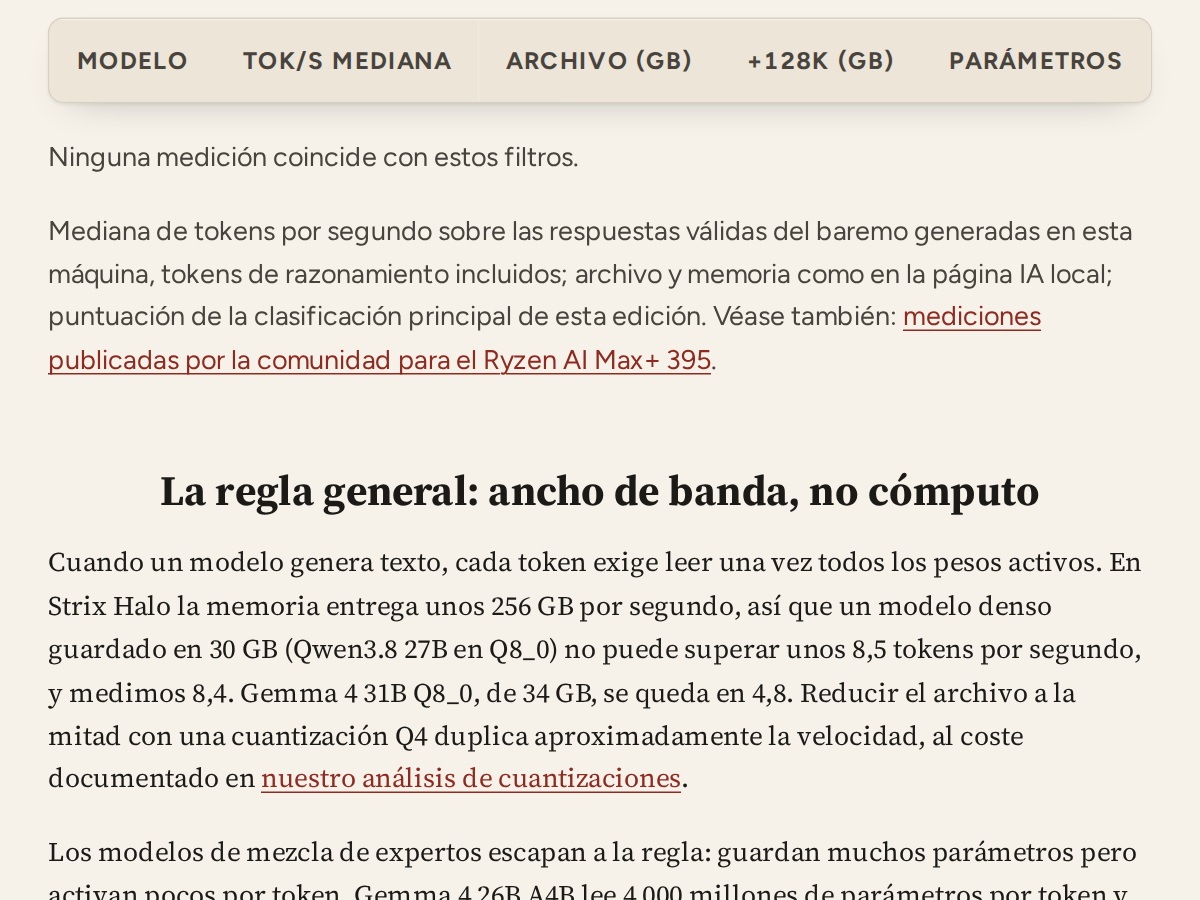
Los modelos locales se ejecutaron en un Framework Desktop con un AMD Ryzen AI Max+ 395. Sus 128 GB de memoria unificada están disponibles tanto para el procesador como para la unidad gráfica, lo que permite cargar modelos más grandes que en la mayoría de las tarjetas gráficas de consumo. Un segundo equipo con una NVIDIA GeForce RTX 5070 Ti generó las respuestas de algunos modelos ligeros.
Las velocidades de generación medidas en este equipo, modelo por modelo y cuantización por cuantización, están en la página Velocidad Strix Halo.