

¿Cuál es la mejor IA local para escribir en español?
La respuesta está en la tabla y cambia cuando entran nuevos modelos o nuevas comparaciones, así que no la fijamos por escrito.
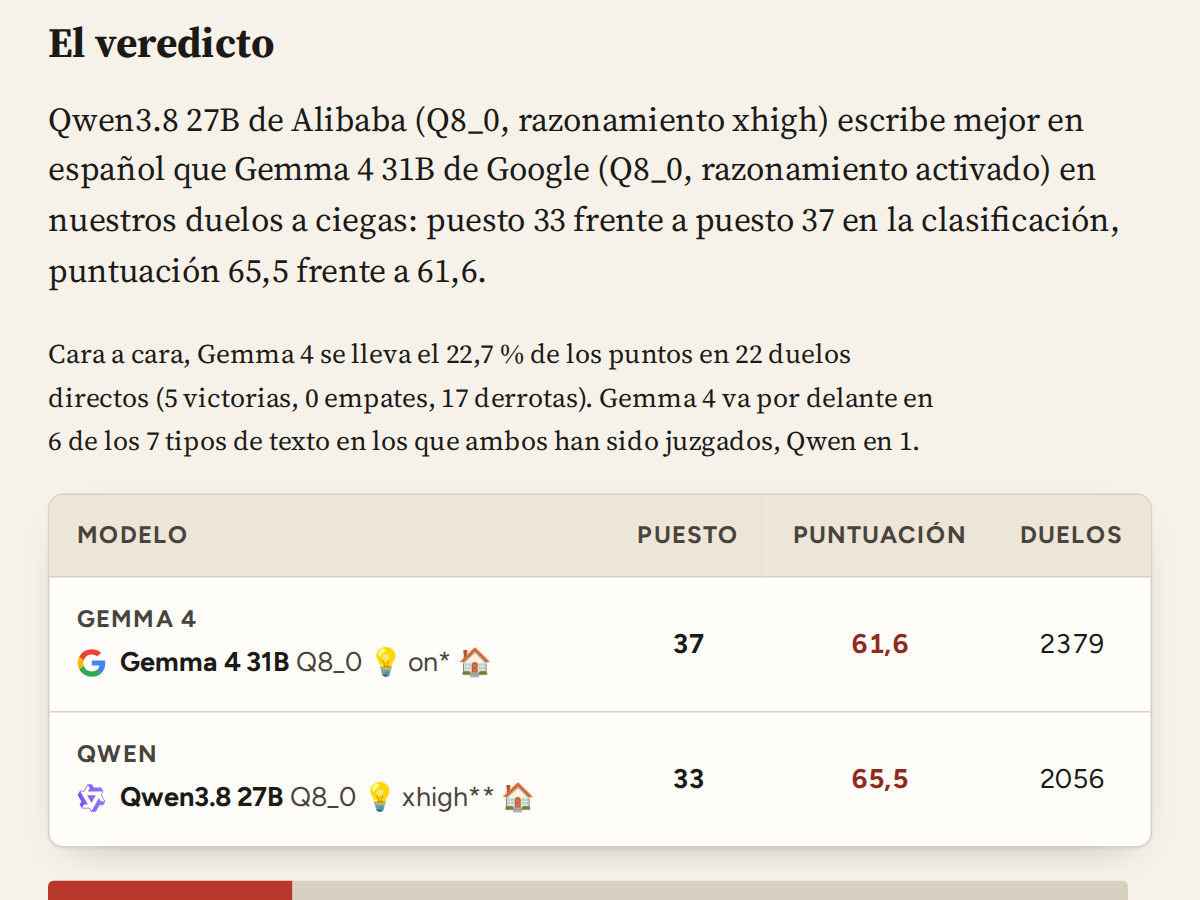
Qwen3.8 27B de Alibaba (Q8_0, razonamiento xhigh) es la mejor variante local de la selección actual, con una puntuación de 63,7. Necesita 38,7 GB con un contexto de 128K.
Qué cuenta aquí como «local»
Cuatro condiciones, aplicadas de forma estricta:
- Pesos abiertos. Los archivos del modelo deben poder descargarse públicamente y ejecutarse fuera de la infraestructura de la empresa que lo publica.
- Ejecutable de verdad sin conexión. No una API restringida con un nombre que suena a abierto.
- Menos de 256 000 millones de parámetros totales. Estrictamente por debajo del umbral.
- Ya evaluado en este sitio. Sin estimaciones ni entradas provisionales en la clasificación.
El límite se aplica a los parámetros totales, también en los modelos de mezcla de expertos. Conviene decirlo claramente porque es un error frecuente y con consecuencias: un modelo de expertos que activa una pequeña parte de sus parámetros en cada token necesita igualmente tener todos sus pesos en memoria. Los parámetros totales deciden la admisión y la memoria necesaria; los activos influyen en la velocidad. Cuando se conocen los dos, el nombre del modelo los conserva (por ejemplo, 35B A3B), para que la cifra de activos oriente sobre la velocidad sin confundirse con una cifra de memoria.
Lo que estos criterios no exigen es que hayamos generado las respuestas del modelo en una máquina propia. Un modelo es admisible porque sus pesos están disponibles y puede ejecutarse en local, no por el lugar donde se produjeron sus textos. Cuando la velocidad de una variante se midió en nuestro equipo, la cifra se presenta como una medición de Baremo IA.
Qué es la cuantización y qué efecto tiene
La cuantización consiste en representar los pesos del modelo con menos bits. El efecto inmediato es mecánico: el archivo ocupa menos y la huella en memoria baja. En inferencia local, donde el cuello de botella suele ser el ancho de banda de memoria, esa reducción también puede traducirse en más velocidad.
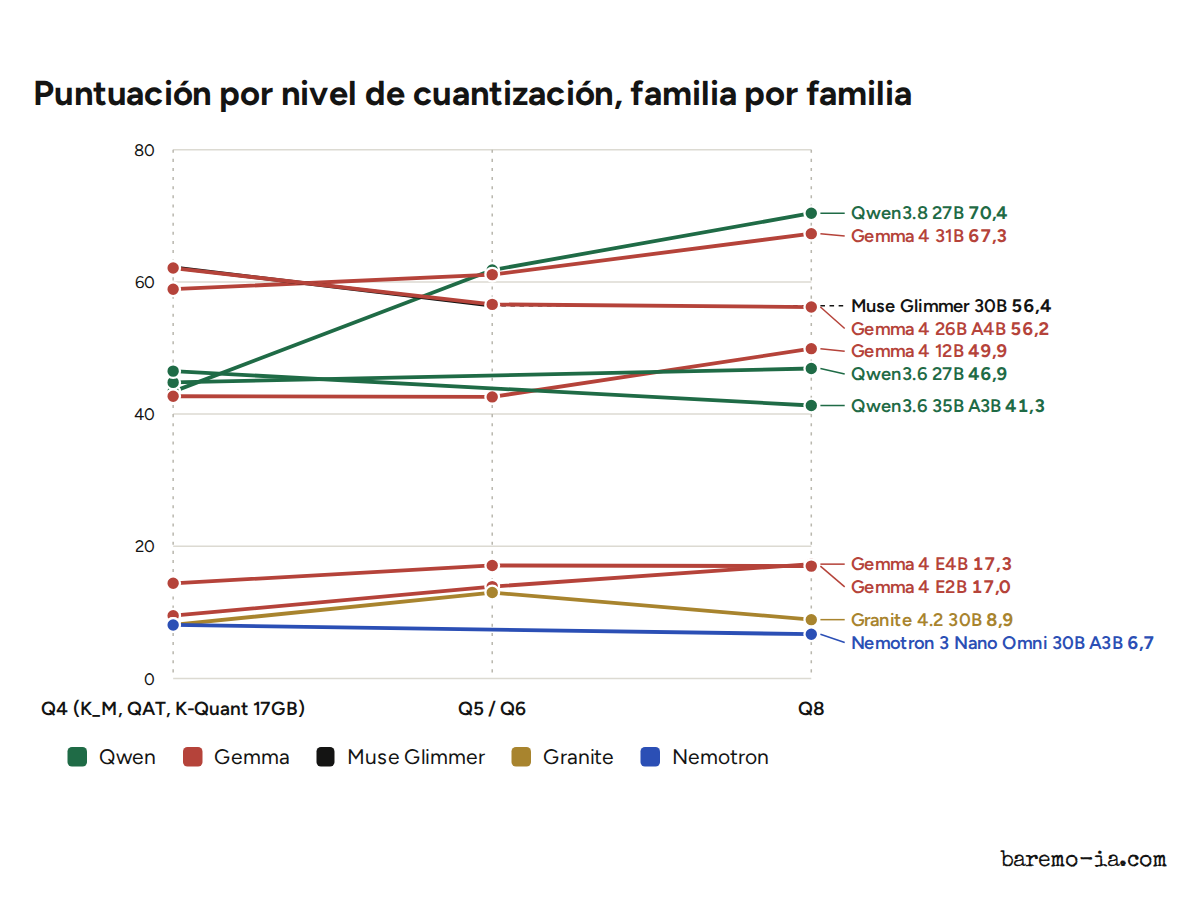
El efecto sobre la calidad es donde hay que ser honesto. La cuantización puede degradar el texto, y cuánto depende del modelo, del método, de la tarea, del idioma, de la longitud del contexto y del nivel de cuantización. No existe un porcentaje universal de «calidad conservada», y desconfía de cualquier cifra que se presente así.
Estos son los niveles que verás en el filtro:
- Q8 — variante de ocho bits. La usamos como referencia práctica de alta calidad, sin afirmar que sea matemáticamente idéntica a BF16/FP16; la diferencia real es una cuestión empírica, no un axioma.
- Q4 QAT — modelo preparado o entrenado teniendo en cuenta una ejecución en cuatro bits. Es un checkpoint distinto, no una conversión posterior, y por eso ocupa su propia fila.
- Q4_K_M — cuantización GGUF de cuatro bits aplicada después del entrenamiento, con precisión mixta según la capa. No es QAT, aunque ambas se anuncien como «4 bits».
- Q6 — punto intermedio (Q6_K). Hay variantes evaluadas, y se muestran por defecto.
Las dos variantes K-Quant de Muse Glimmer
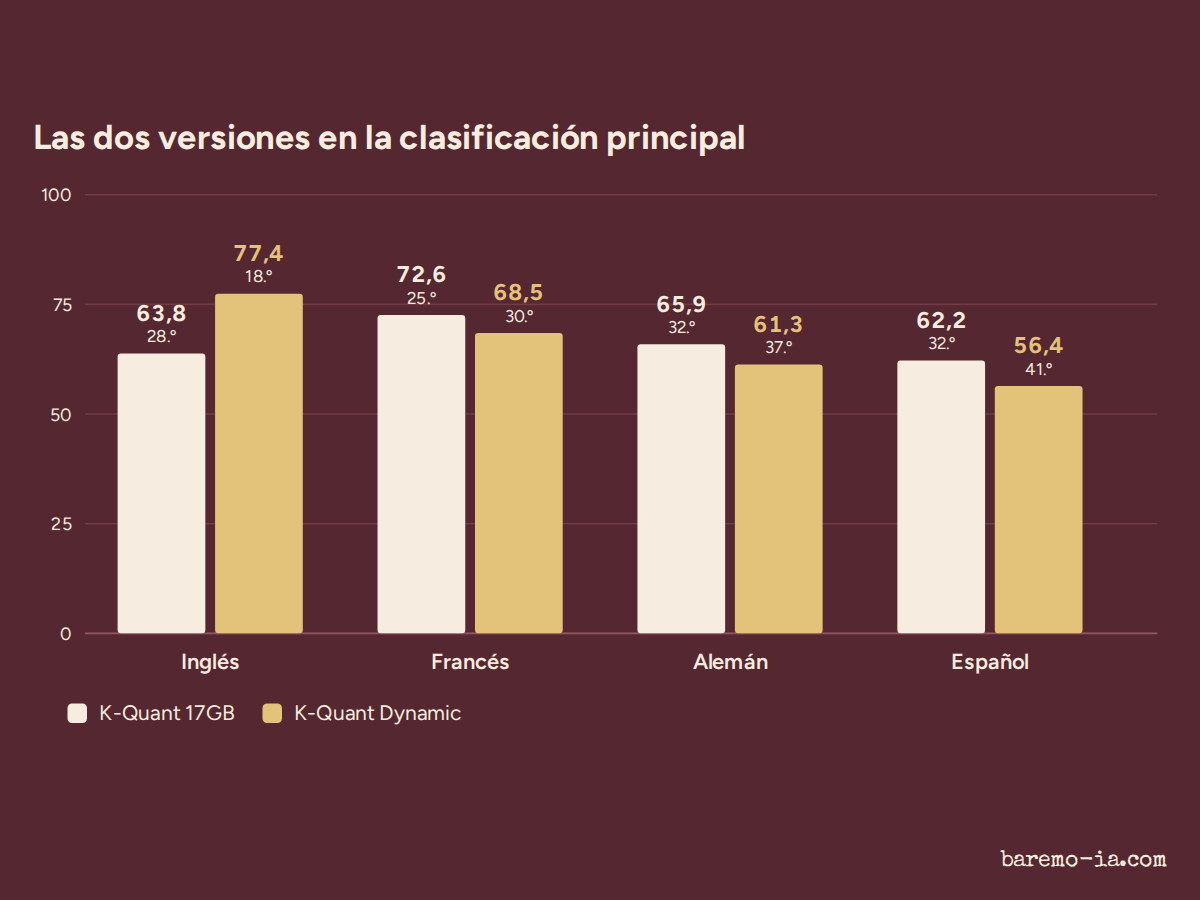
Meta publica Muse Glimmer 30B en dos archivos GGUF poco habituales, de la clase de los cuatro a cinco bits por peso. K-Quant Dynamic conserva ciertos tensores con mayor precisión y apunta a 32 GB de VRAM; K-Quant 17GB comprime más y apunta a 24 GB. No son archivos Q4_K_M, así que mantenemos sus nombres exactos y los evaluamos como variantes separadas. En el filtro tienen sus propias etiquetas, «≈ Q4 (K-Quant)» para 17GB y «≈ Q5 (K-Quant Dynamic)» para Dynamic: el signo ≈ indica una clase de tamaño comparable, no una codificación idéntica.
Meta comunica una degradación media del 0,2 % y del 1,0 %, respectivamente, en quince benchmarks comunes. Son mediciones de la empresa, no puntuaciones de escritura de Baremo IA ni garantías para la prosa en español, inglés, francés o alemán. Nuestra clasificación y la comparación directa miden los dos archivos por separado con consignas redactadas de forma nativa.
Recomendaciones por hardware
La pregunta que más nos hacen no es «qué modelo escribe mejor» sino «qué modelo escribe mejor en mi equipo». Esta escalera la responde para los tamaños de memoria habituales, desde una tarjeta gráfica de 8 GB hasta una estación de trabajo con 128 GB de memoria unificada. Cada peldaño nombra la variante que mejor escribe entre las que caben y la variante más rápida que hemos medido que también cabe. Los peldaños en los que nada cambia se fusionan.
8 GB
RTX 4060 · RTX 5060 · RX 7600
Mejor calidad
 Gemma 4 E2B 💡 🏠
Alternativa medida más rápida
Gemma 4 E2B 💡 🏠
12 GB
RTX 3060 12 GB · RTX 4070 · RTX 5070
Mejor calidad
Gemma 4 12B 💡 🏠
Alternativa medida más rápida
Gemma 4 E2B 💡 🏠
16 GB
RTX 4060 Ti 16 GB · RTX 5070 Ti · RTX 5080 · RX 9070 XT · Mac con 24 GB de memoria unificada
Mejor calidad
Gemma 4 12B 💡 🏠
Alternativa medida más rápida
Gemma 4 E2B 💡 🏠
24 GB
RTX 3090 · RTX 4090 · RX 7900 XTX · Mac con 32 GB
Mejor calidad
 Muse Glimmer 30B 💡 🏠
Alternativa medida más rápida
Gemma 4 E2B 💡 🏠
32 GB
RTX 5090 · Mac con 48 GB
Mejor calidad
Muse Glimmer 30B 💡 🏠
Alternativa medida más rápida
Gemma 4 26B A4B ↯ 🏠
48–128 GB
48 GB: RTX 6000 Ada · dos tarjetas de 24 GB · Mac con 64 GB · Strix Halo 64 GB64 GB: Mac con 96 GB96 GB: RTX PRO 6000 · Mac con 128 GB · DGX Spark · Strix Halo 128 GB (96 GB asignados)128 GB: Mac Studio con 192 GB o más
Mejor calidad
 Qwen3.8 27B 💡 🏠
Alternativa medida más rápida
Gemma 4 26B A4B ↯ 🏠
Son referencias de carga, no garantías: contexto, caché KV, lote y runtime cambian la huella. Las velocidades de Baremo IA se midieron en el equipo Strix Halo descrito en «Sobre el autor» y no predicen otra plataforma.
Cómo se decide que «cabe»
Una variante entra en un peldaño cuando su necesidad de memoria estimada es igual o inferior al tamaño del peldaño. La estimación toma el archivo GGUF, más un 8 % para los búferes del runtime, más 2 GB para un contexto corto, redondeado al siguiente tamaño de tarjeta estándar. Es prudente para instrucciones cortas y optimista para documentos largos: la cifra «a 128K» de cada tarjeta muestra lo que la misma variante necesita con un contexto de 128 000 tokens, caché KV incluida, y en algunos modelos duplica el presupuesto. Si trabajas con textos largos, lee esa cifra y no el tamaño del archivo. Las cifras siguen los ajustes por defecto de LM Studio, en gigabytes decimales como él: el archivo GGUF que probamos más la caché F16 de las capas de atención completa (las capas de ventana deslizante y las recurrentes apenas crecen, por eso Gemma 4 y Qwen 3.x necesitan mucho menos de lo que sugiere un cálculo ingenuo), con Flash Attention activada. 128K significa 131 072 tokens, el ajuste que ofrece LM Studio. La tabla de la clasificación también puede mostrar una caché Q8, casi la mitad de pesada, y el tamaño de los archivos MLX para Mac.
Tarjeta gráfica dedicada o memoria unificada
Una tarjeta gráfica ofrece el ancho de banda de memoria que hace rápida la generación, pero su tamaño es fijo: 8, 12, 16, 24 o 32 GB en las tarjetas de consumo. Los equipos con memoria unificada (Mac con Apple Silicon, AMD Strix Halo, Nvidia DGX Spark) comparten un único depósito entre procesador y gráficos. Admiten modelos que ninguna tarjeta de consumo puede cargar, pero ese depósito es más lento y no está disponible por completo para el modelo. Cuenta aproximadamente tres cuartas partes de la memoria unificada como utilizables: por eso un Mac de 24 GB está en el peldaño de 16 GB y un Strix Halo de 64 GB en el de 48 GB. Los ejemplos bajo cada peldaño ya aplican esa regla.
Qué aporta tener más memoria
Por encima de 48 GB, ningún modelo local más grande escribe hoy mejor español que las mejores versiones Q8 de unos 30 000 millones de parámetros, así que la primera opción deja de cambiar y los peldaños superiores se fusionan. La memoria extra aporta de todos modos tres cosas: la versión Q8 de una familia en lugar de su Q4 (la sección sobre cuantización muestra dónde importa), un contexto largo sin desbordar a la memoria del sistema y espacio para mantener dos modelos cargados. Lo que no aporta es velocidad: la generación está limitada por el ancho de banda, y una tarjeta de 24 GB suele ser más rápida que un depósito unificado de 128 GB con el mismo modelo.
Sobre las cifras de velocidad
Los tokens por segundo se midieron en nuestro propio equipo Strix Halo, descrito en la página «Sobre el autor», tokens de razonamiento incluidos. Comparan variantes entre sí; no predicen tu equipo. Una tarjeta dedicada suele generar entre dos y cuatro veces más rápido que esa máquina con un modelo que cabe en su memoria; un procesador de portátil sin acelerador, mucho más despacio. Y cuando parte del modelo se descarga al procesador, la velocidad cae mucho aunque el modelo técnicamente «quepa».
Calidad frente a velocidad
Son dos ejes independientes y esta página los mantiene separados a propósito. La clasificación mide la calidad de escritura en español; las recomendaciones por hardware hablan de si el modelo cabe y a qué ritmo genera. Un modelo excelente que produce texto muy despacio puede ser perfectamente razonable para redactar y revisar sin prisa, y un modelo más modesto pero fluido puede ser mejor compañero para el trabajo iterativo. Decidir cuál te conviene requiere ambos datos, no uno solo.
Por qué usar una IA local
Los motivos son concretos. Cuando el runtime y sus integraciones funcionan enteramente en local, tus textos no tienen por qué salir de tu equipo, lo que importa cuando trabajas con material confidencial, inédito o sujeto a acuerdos de cliente. Funciona sin conexión. No dependes de que un proveedor cambie el modelo bajo el mismo nombre, ajuste sus filtros o retire una versión. Y el coste de uso, una vez descargado el modelo, no está ligado al número de peticiones.
También hay una precisión de vocabulario que conviene hacer, porque en las búsquedas se usa «open source» para casi todo. El criterio técnico de esta página son los pesos abiertos: que puedas descargar y ejecutar el modelo. Eso no equivale por sí solo a una licencia open source; la aplicación de ese marco al conjunto de artefactos de un modelo sigue siendo objeto de debate, y muchas licencias restringen ciertos usos comerciales. La licencia es un asunto legal que debes comprobar para tu caso; no dice nada sobre la calidad del texto, y nosotros no la puntuamos.
Preguntas frecuentes
¿Qué modelo local escribe mejor en español?
El que encabeza la tabla de esta página con los filtros por defecto. Cambia cuando se incorporan modelos o comparaciones nuevas, así que la respuesta vive en la clasificación dinámica y no en este texto.
¿Qué significa «LLM local»?
Un LLM es un gran modelo de lenguaje, el tipo de IA que genera texto. Un LLM local es uno que descargas y ejecutas en tu propio ordenador, sin conexión, en lugar de usar un servicio a través de internet.
¿Cuánta VRAM necesito?
Depende del modelo, de la cuantización y del contexto que quieras usar. Las recomendaciones por hardware indican, de 8 a 128 GB, qué variante evaluada cabe con el margen aplicado; si no hay una recomendación defendible, la tarjeta queda vacía.
¿La cuantización estropea el texto?
Puede afectarlo, y el efecto varía según el modelo, el método, la tarea y el idioma. No damos porcentajes universales: solo publicamos conclusiones cuando disponemos de comparaciones emparejadas entre variantes del mismo modelo.
¿Q4 QAT y Q4_K_M son lo mismo?
No. Q4 QAT es un checkpoint preparado o entrenado contando con la ejecución en cuatro bits; Q4_K_M es una cuantización GGUF aplicada después del entrenamiento, con precisión mixta. Van en filas separadas.
¿Por qué hay modelos en la nube entre los adversarios?
Porque conservamos las puntuaciones de la clasificación general en español. Eso mantiene una escala común entre ambas páginas y aporta muchos más datos por modelo del que tendría un torneo cerrado entre modelos locales.
¿Por qué el umbral de 256 000 millones de parámetros?
El umbral centra esta página en los modelos que siguen siendo plausibles en un equipo personal o en una estación de trabajo compacta. Se aplica a los parámetros totales, también en los modelos de mezcla de expertos, porque todos los pesos tienen que estar en memoria aunque solo una parte trabaje en cada token. Un modelo más grande puede ejecutarse con hardware suficiente, pero queda fuera de esta página.
¿La memoria unificada vale lo mismo que la VRAM?
En capacidad, a menudo es mejor: un equipo con memoria unificada carga modelos que ninguna tarjeta gráfica de consumo puede alojar. En ancho de banda, en general no, y esa diferencia se nota en una generación más lenta. No las trates como equivalentes.
¿Por qué falta un modelo local conocido?
Porque todavía no se ha evaluado con el corpus en español: solo entran en la clasificación los modelos ya evaluados, sin estimaciones. Su ausencia no debe leerse como un resultado negativo.
¿Qué significan los iconos 💡 y ↯?
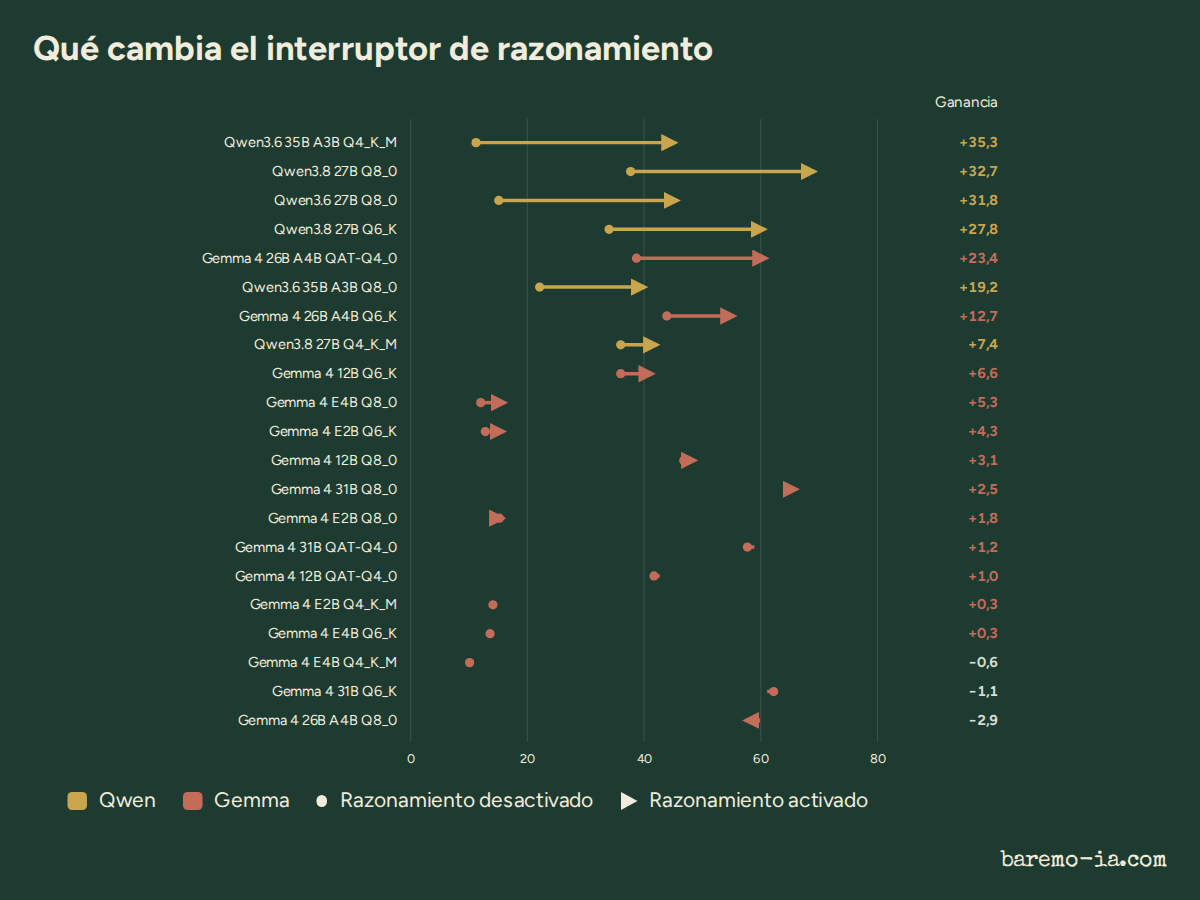
💡 indica que el modelo generó con el razonamiento activado y ↯ que lo hizo sin él. Cuando las pruebas técnicas no permiten determinarlo, el estado queda como desconocido en lugar de asumirlo.
¿Cada cuánto se actualiza esta página?
En cada actualización del sitio: la clasificación, los filtros y las recomendaciones por memoria se generan a partir de los datos, y las puntuaciones siguen moviéndose porque los duelos se siguen juzgando. La generación local está suspendida desde el 22 de septiembre de 2026, así que por ahora no entran variantes locales nuevas.