Q4, Q6 o Q8: la cuantización no cuesta nada en unos modelos y veintisiete puntos en otros
El mismo modelo, tres archivos, tres puntuaciones. En español, Qwen3.8 27B pierde 27 puntos entre Q8_0 y Q4_K_M, la mayor caída de las cuatro ediciones, mientras que Gemma 4 26B A4B escribe mejor en su archivo QAT de 4 bits que en Q8 y Qwen3.6 27B apenas nota la diferencia. No hay regla general, solo mediciones.
La cuantización reduce un modelo guardando sus pesos con menos bits. Un modelo de 27 000 millones de parámetros ocupa 30 GB en Q8_0 y 18 GB en Q4_K_M: la diferencia entre caber o no en una tarjeta de 32 GB. Todas las guías dicen que el archivo pequeño escribe algo peor. Hemos medido cuánto, con consignas en español y los mismos duelos a ciegas que construyen la clasificación, entre 1 000 y 1 800 por versión. Las puntuaciones son las de la clasificación en español: 50 significa una probabilidad de uno entre dos de vencer al modelo medio.
El mismo modelo, tres archivos, tres puntuaciones: las líneas no son paralelas
Puntuación por nivel de cuantización, familia por familia
Puntuación de cada versión con el razonamiento activado. Las líneas unen las versiones de una misma familia; archivos de 4 bits a la izquierda, de 8 bits a la derecha.
- Qwen
- Gemma
- Muse Glimmer
- Granite
- Nemotron
Ver como tabla de datos
| Familia | Q4 (K_M, QAT, K-Quant 17GB) | Q5 / Q6 | Q8 |
|---|---|---|---|
| Qwen3.8 27B | 43,4 | 61,8 | 70,4 |
| Gemma 4 31B | 58,9 | 61,1 | 67,3 |
| Muse Glimmer 30B | 62,2 | 56,4 | — |
| Gemma 4 26B A4B | 62,1 | 56,6 | 56,2 |
| Gemma 4 12B | 42,7 | 42,6 | 49,9 |
| Qwen3.6 27B | 44,8 | — | 46,9 |
| Qwen3.6 35B A3B | 46,5 | — | 41,3 |
| Gemma 4 E4B | 9,5 | 13,9 | 17,3 |
| Gemma 4 E2B | 14,4 | 17,1 | 17,0 |
| Granite 4.2 30B | 8,1 | 13,0 | 8,9 |
| Nemotron 3 Nano Omni 30B A3B | 8,1 | — | 6,7 |
Si la cuantización fuera un impuesto fijo, todas las líneas subirían de izquierda a derecha con la misma pendiente. No lo hacen: algunas son planas, una baja y otra se desploma. Ese es todo el hallazgo; el resto del artículo recorre las líneas.
Donde la cuantización sale gratis: Gemma 4 26B A4B y Qwen3.6 27B
Gemma 4 26B A4B es el caso curioso del español: su archivo QAT-Q4_0, de menos de 16 GB, obtiene 62,1 puntos, por encima de Q6_K (56,6) y de Q8_0 (56,2). Google entrenó esa versión para sobrevivir a los 4 bits, y aquí no solo sobrevive, gana. Qwen3.6 27B pierde apenas dos puntos entre Q8 y Q4, y Gemma 4 31B ocho, de 67,3 a 58,9, que en su caso siguen siendo puestos altos del campo local.
Donde sale cara: Qwen3.8 27B pierde 27 puntos entre Q8 y Q4
Es la mayor caída de las cuatro ediciones. Qwen3.8 27B, el mejor modelo local en español con 70,4 puntos en Q8_0, baja a 61,8 en Q6_K y a 43,4 en Q4_K_M. El archivo de 18 GB que gana en inglés y en francés es, en español, un modelo de mitad de tabla. Granite 4.2 30B es flojo en las tres versiones, entre 8,1 y 13,0, y Nemotron 3 Nano también.
Q6 rara vez es la respuesta
De las siete familias del gráfico con versión Q6_K, Q6 solo es lo mejor de la suya dos veces en español, en Granite 4.2 30B y en Gemma 4 E2B (por una décima), y en las dos con puntuaciones muy bajas, 13,0 y 17,1. Ahorra menos memoria que Q4 y casi nunca conserva la calidad de Q8. Si tienes que elegir a ciegas, elige Q8 cuando quepa, un Q4 QAT o K-Quant cuando no, y sáltate el Q6.
Qué cabe en 16 y 24 GB, y cuánto cuesta en puntos
Tamaño del archivo frente a puntuación
Cada versión de la tabla: tamaño del archivo GGUF y puntuación. Las líneas discontinuas marcan 16 GB y 24 GB de memoria.
- Qwen
- Gemma
- Muse Glimmer
- Granite
- Nemotron
Ver como tabla de datos
| Modelo | Tamaño del archivo (GB) | Puntuación |
|---|---|---|
| Qwen3.8 27B Q8_0 | 29,0 | 70,4 |
| Gemma 4 31B Q8_0 | 32,6 | 67,3 |
| Muse Glimmer 30B K-Quant 17GB | 16,8 | 62,2 |
| Gemma 4 26B A4B QAT-Q4_0 | 14,4 | 62,1 |
| Qwen3.8 27B Q6_K | 22,4 | 61,8 |
| Gemma 4 31B Q6_K | 25,2 | 61,1 |
| Gemma 4 31B QAT-Q4_0 | 17,7 | 58,9 |
| Gemma 4 26B A4B Q6_K | 22,6 | 56,6 |
| Muse Glimmer 30B K-Quant Dynamic | 19,7 | 56,4 |
| Gemma 4 26B A4B Q8_0 | 26,9 | 56,2 |
| Gemma 4 12B Q8_0 | 12,7 | 49,9 |
| Qwen3.6 27B Q8_0 | 28,6 | 46,9 |
| Qwen3.6 35B A3B Q4_K_M | 21,2 | 46,5 |
| Qwen3.6 27B Q4_K_M | 16,5 | 44,8 |
| Qwen3.8 27B Q4_K_M | 16,8 | 43,4 |
| Gemma 4 12B QAT-Q4_0 | 7,0 | 42,7 |
| Gemma 4 12B Q6_K | 9,8 | 42,6 |
| Qwen3.6 35B A3B Q8_0 | 36,9 | 41,3 |
| Gemma 4 E4B Q8_0 | 8,0 | 17,3 |
| Gemma 4 E2B Q6_K | 3,8 | 17,1 |
| Gemma 4 E2B Q8_0 | 5,0 | 17,0 |
| Gemma 4 E2B Q4_K_M | 3,4 | 14,4 |
| Gemma 4 E4B Q6_K | 6,2 | 13,9 |
| Granite 4.2 30B Q6_K | 24,0 | 13,0 |
| Gemma 4 E4B Q4_K_M | 5,3 | 9,5 |
| Granite 4.2 30B Q8_0 | 31,1 | 8,9 |
| Granite 4.2 30B Q4_K_M | 17,7 | 8,1 |
| Nemotron 3 Nano Omni 30B A3B Q4_K_M | 24,5 | 8,1 |
| Nemotron 3 Nano Omni 30B A3B Q8_0 | 33,6 | 6,7 |
Las líneas discontinuas marcan los dos techos de memoria habituales. Por debajo de 16 GB, el mejor redactor es Gemma 4 26B A4B QAT-Q4_0 con 62,1; por debajo de 24 GB, Muse Glimmer 17GB con 62,2 y Qwen3.8 27B Q6_K con 61,8 lo igualan. Las versiones Q8 de la derecha ocupan de 27 a 38 GB, y en español, a diferencia del inglés, en Qwen3.8 sí compran muchos puntos. Que la memoria extra merezca la pena depende del modelo, no de la regla.
La misma medición en inglés, francés y alemán da respuestas distintas
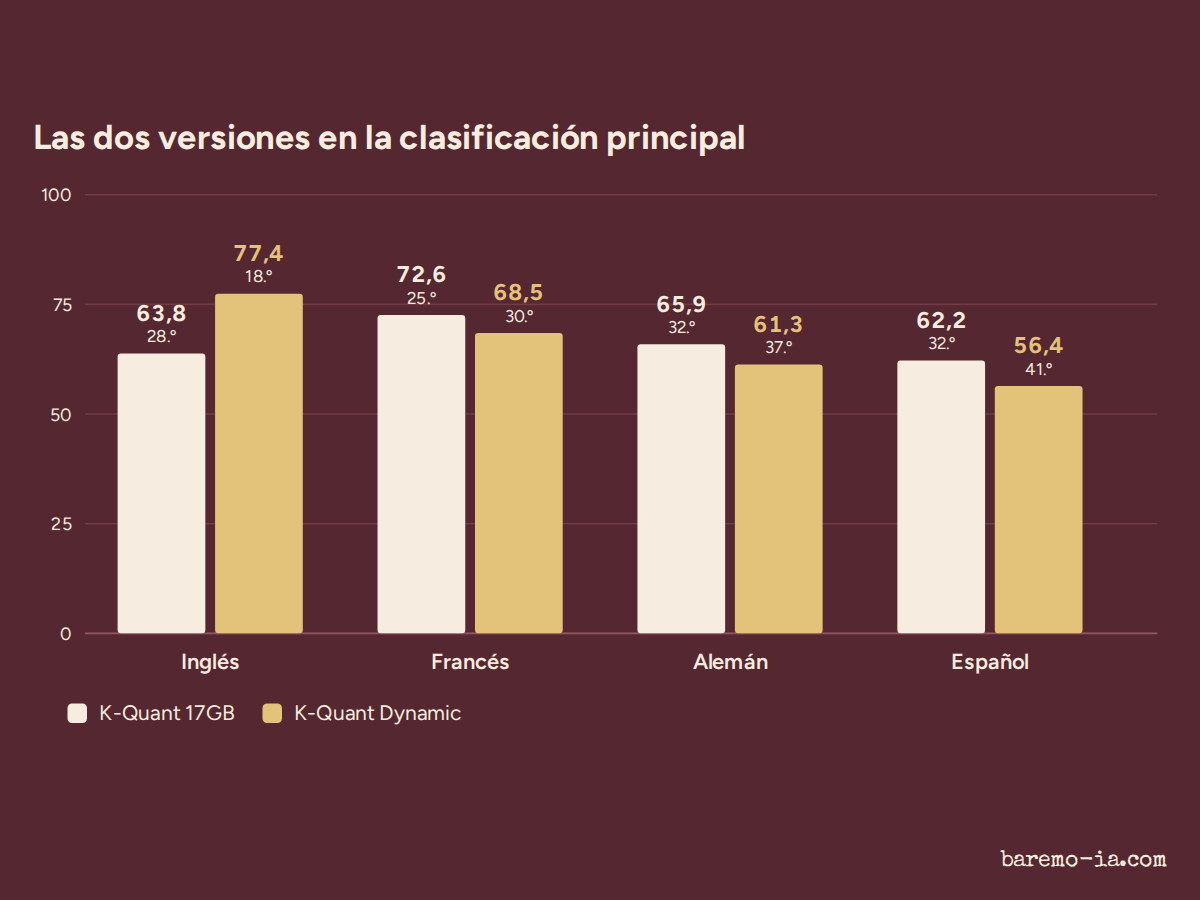
Nada de esto se traslada. En inglés, el Q4 de Qwen3.8 27B es el mejor de su familia; en francés, Gemma 4 12B se hunde en Q6; en alemán, Qwen3.8 pierde 21 puntos. Cada edición de este artículo está escrita a partir de los duelos de su idioma; si escribes en uno de ellos, lee esa.
Conclusión
La cuantización no es un impuesto fijo. En español, Q4 le cuesta 27 puntos a Qwen3.8 27B y nada a Gemma 4 26B A4B, que escribe mejor en QAT-Q4 que en Q8. Q6 rara vez es lo mejor de su familia. Elige Q8 cuando quepa, y comprueba el archivo concreto en el gráfico antes de fiarte de un porcentaje general.