IA local
Una clasificación dinámica de modelos de pesos abiertos para escribir en español, con filtros de cuantización y orientación sobre memoria.
Investigaciones basadas en los datos de Baremo IA sobre cómo los modelos, los ajustes de generación y los protocolos de evaluación afectan a la calidad de los textos.
Una clasificación dinámica de modelos de pesos abiertos para escribir en español, con filtros de cuantización y orientación sobre memoria.
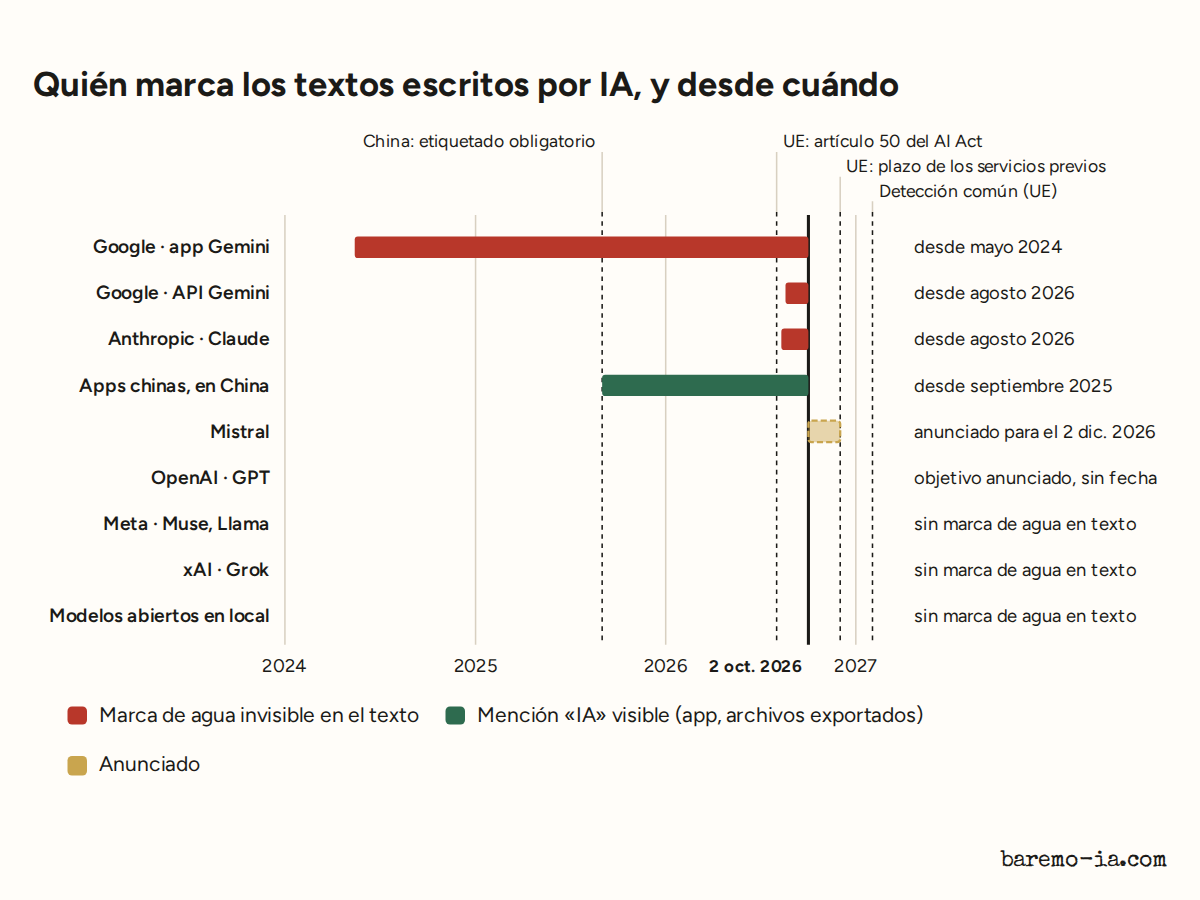
Desde este verano, los textos de Claude y Gemini llevan una marca invisible; desde el 5 de octubre, la llevan también los de ChatGPT y Codex en Europa, y la API de OpenAI puede añadir la marca bajo petición. Los de Grok, Mistral, Meta AI y los modelos que se ejecutan en casa no llevan ninguna, y los servicios chinos se conforman con una mención visible. Pero hoy nadie, fuera de las empresas implicadas, puede comprobar un texto.
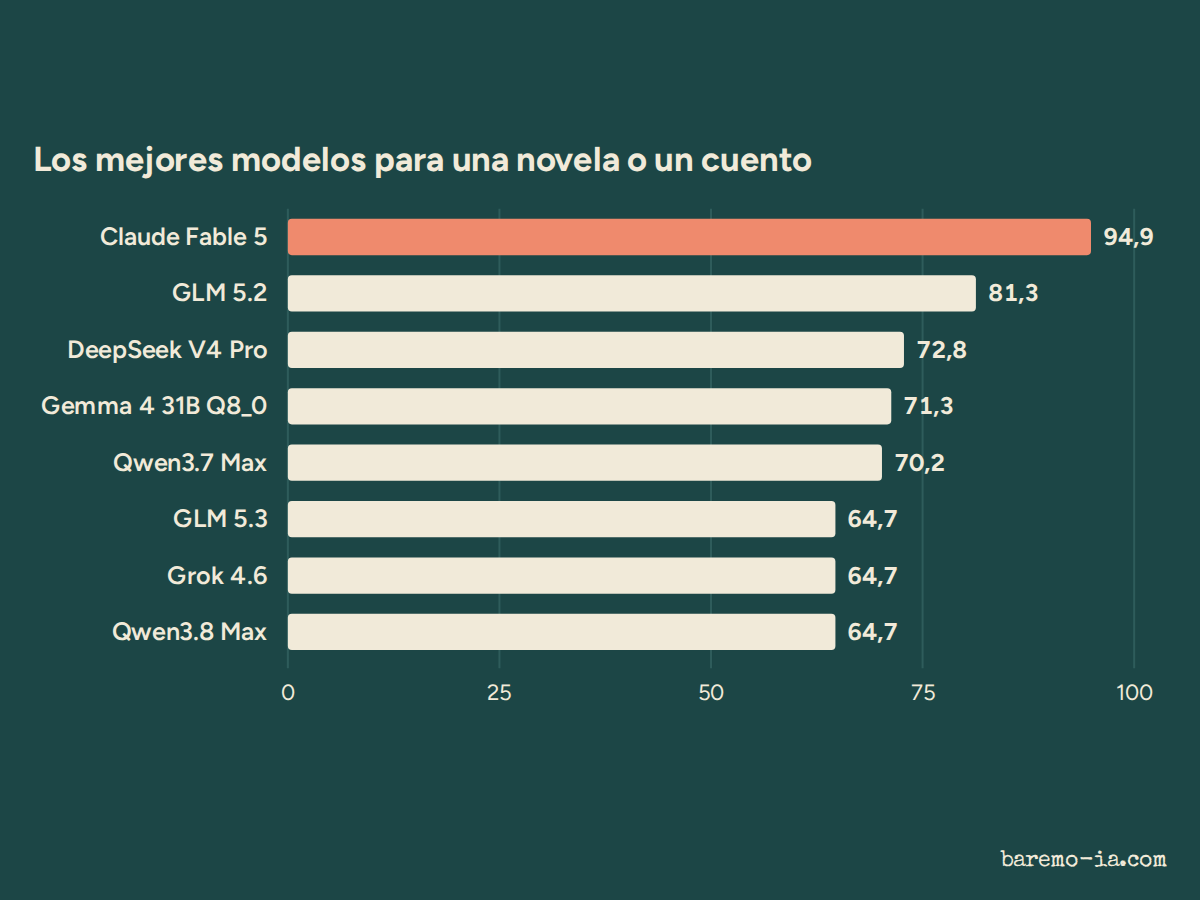
La clasificación tiene un ganador; tus textos tienen varios. Solo con los duelos de un tipo de texto, a 20 de septiembre de 2026, Claude Fable 5 gana la ficción, Claude Opus 5 los correos personales, Claude Fable 5.1 las cartas de presentación y Kimi K3 las explicaciones. Una guía sencilla, tarea por tarea, con el mejor archivo para tu propio ordenador.
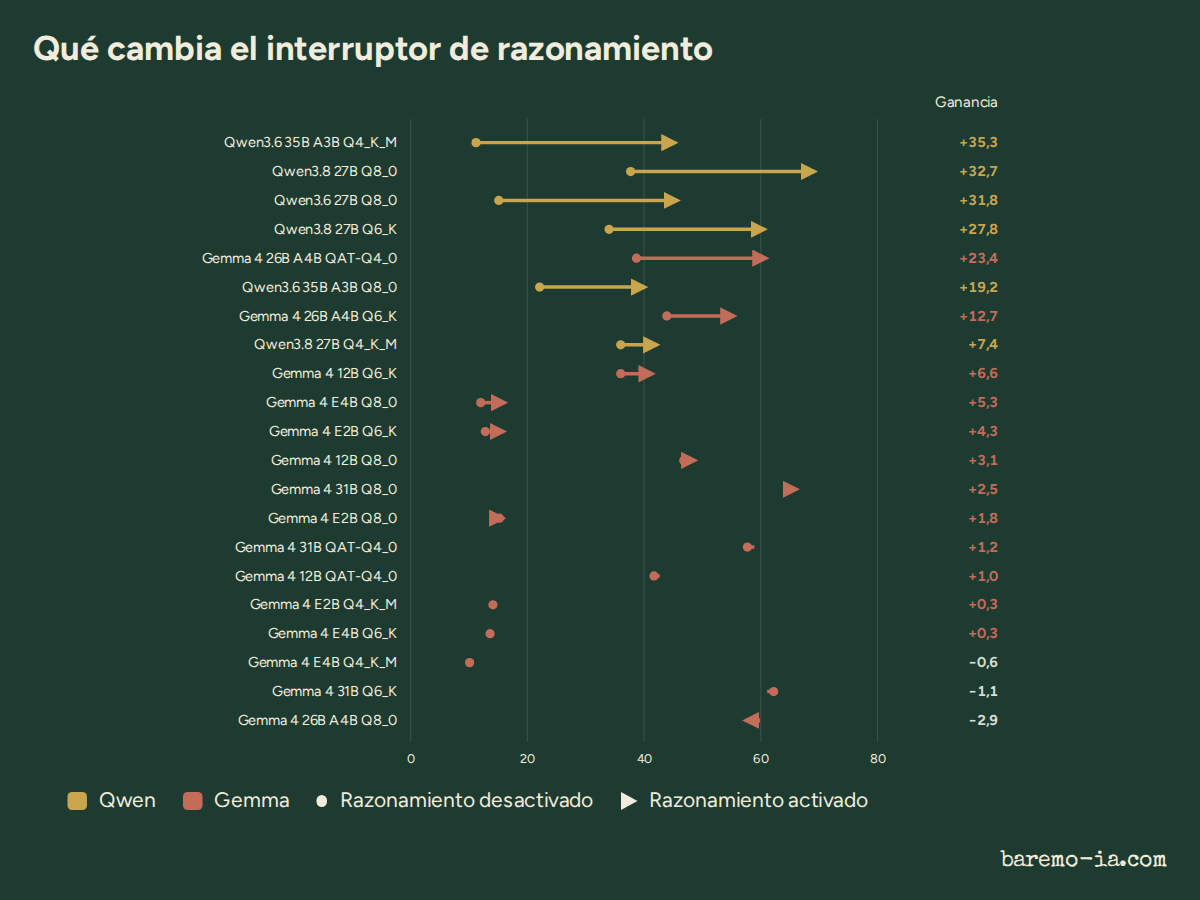
El mismo archivo, las mismas consignas, un solo interruptor. En 21 versiones locales, activar el razonamiento aporta de media 26 puntos a la familia Qwen y 5 a los Gemma 4 de 12B en adelante; los pequeños Gemma E2B y E4B ganan menos de dos. Qwen3.6 35B A3B Q4_K_M gana 35 puntos, más que ningún otro modelo en español.
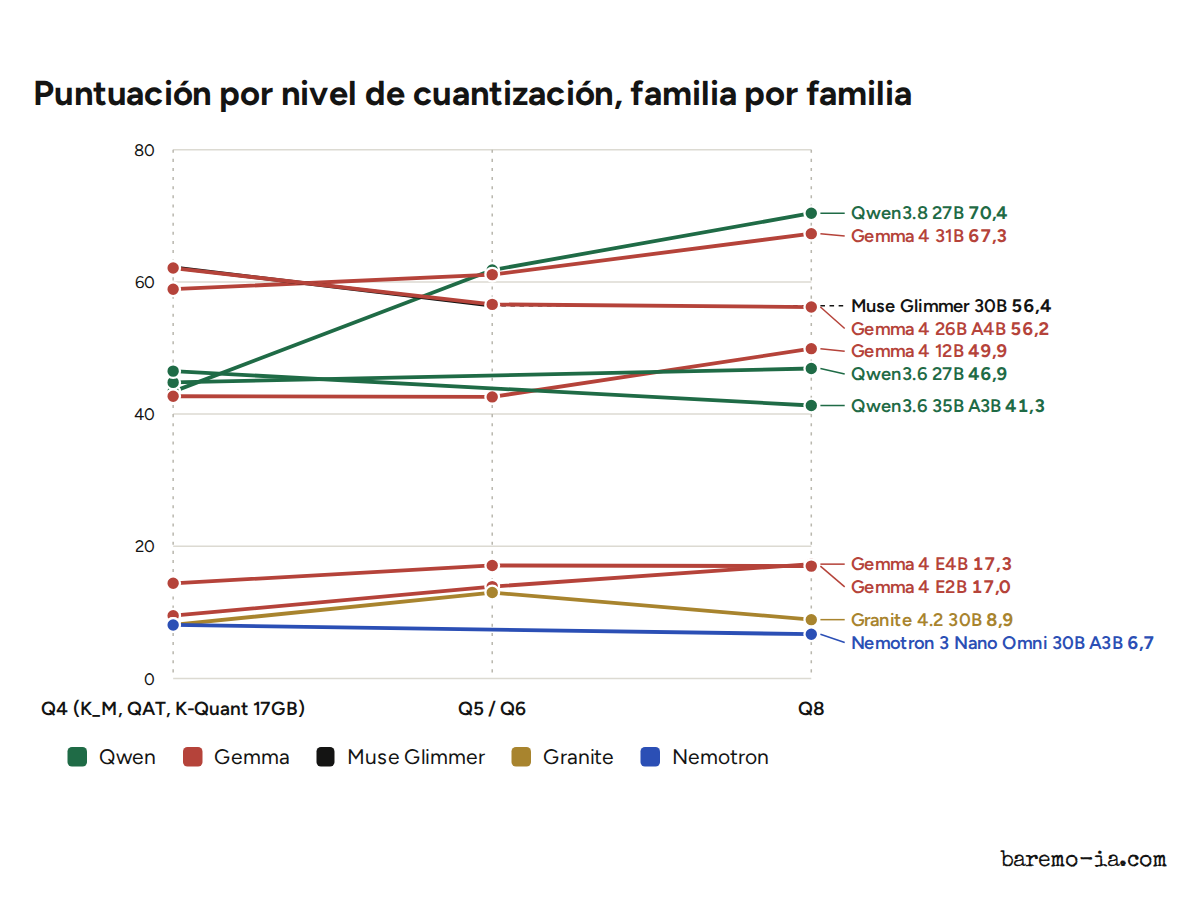
El mismo modelo, tres archivos, tres puntuaciones. En español, Qwen3.8 27B pierde 27 puntos entre Q8_0 y Q4_K_M, la mayor caída de las cuatro ediciones, mientras que Gemma 4 26B A4B escribe mejor en su archivo QAT de 4 bits que en Q8 y Qwen3.6 27B apenas nota la diferencia. No hay regla general, solo mediciones.
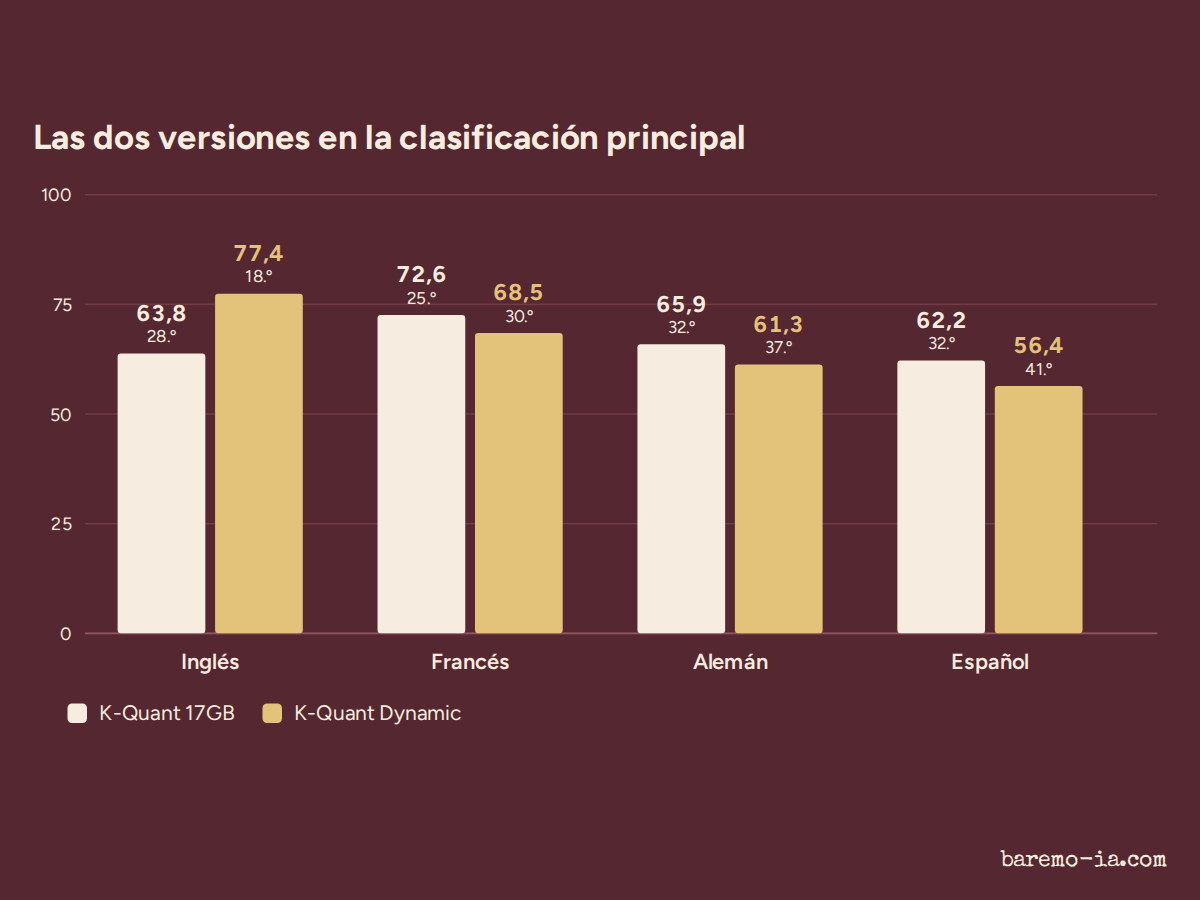
El modelo abierto de Meta suma 62,2 puntos en español con la versión K-Quant 17GB, puesto 32 de la clasificación; la versión Dynamic, mayor y presentada por Meta como la mejor, se queda en 56,4 y pierde 16 duelos directos de 26. El archivo que conviene descargar en español es el pequeño; en inglés, el grande.
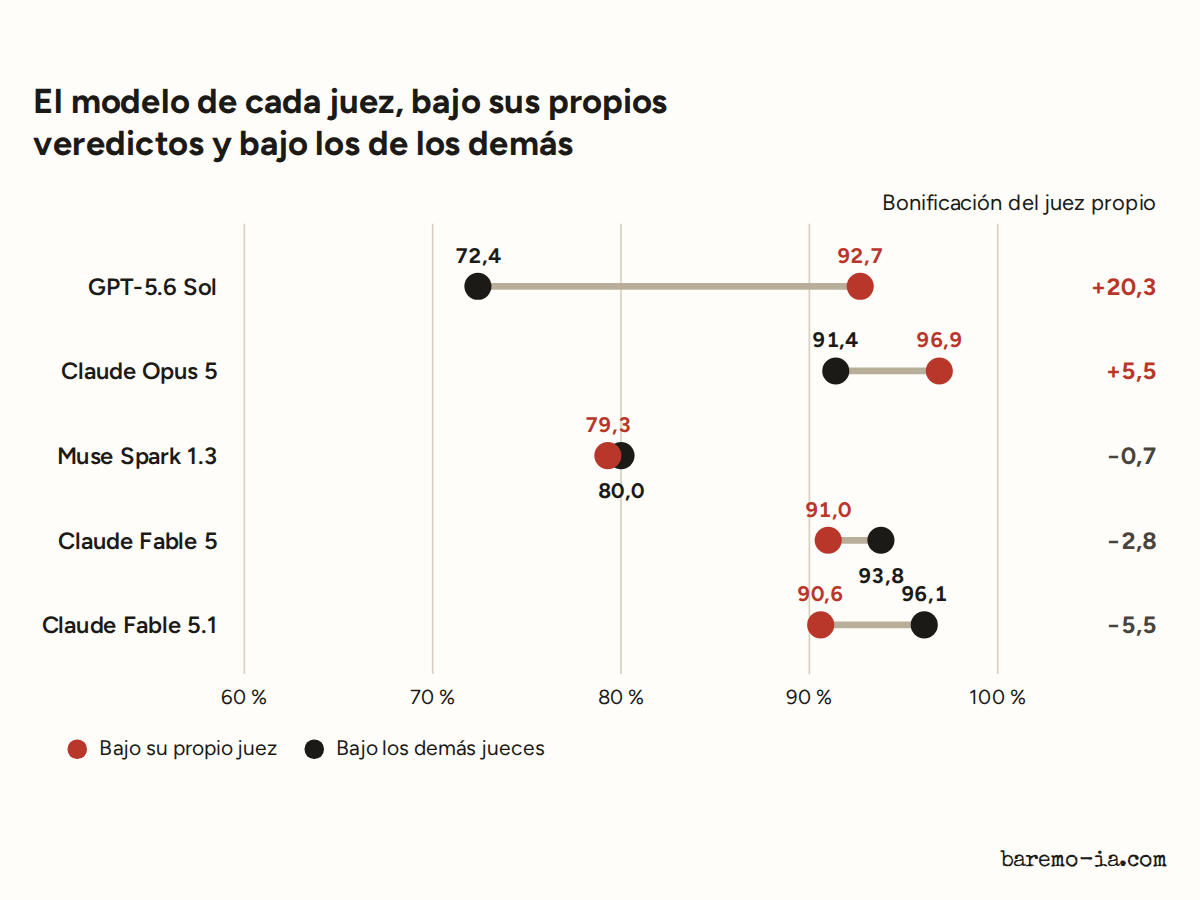
Cuando GPT-5.6 Sol juzga un duelo en el que participa GPT-5.6 Sol, sus textos se llevan el 93 % de los puntos; bajo los demás jueces, el 72 %. Claude Opus 5 se inclina hacia el mismo lado, con menos fuerza. Los dos jueces Claude Fable hacen lo contrario y puntúan su modelo por debajo de lo que hacen los demás.
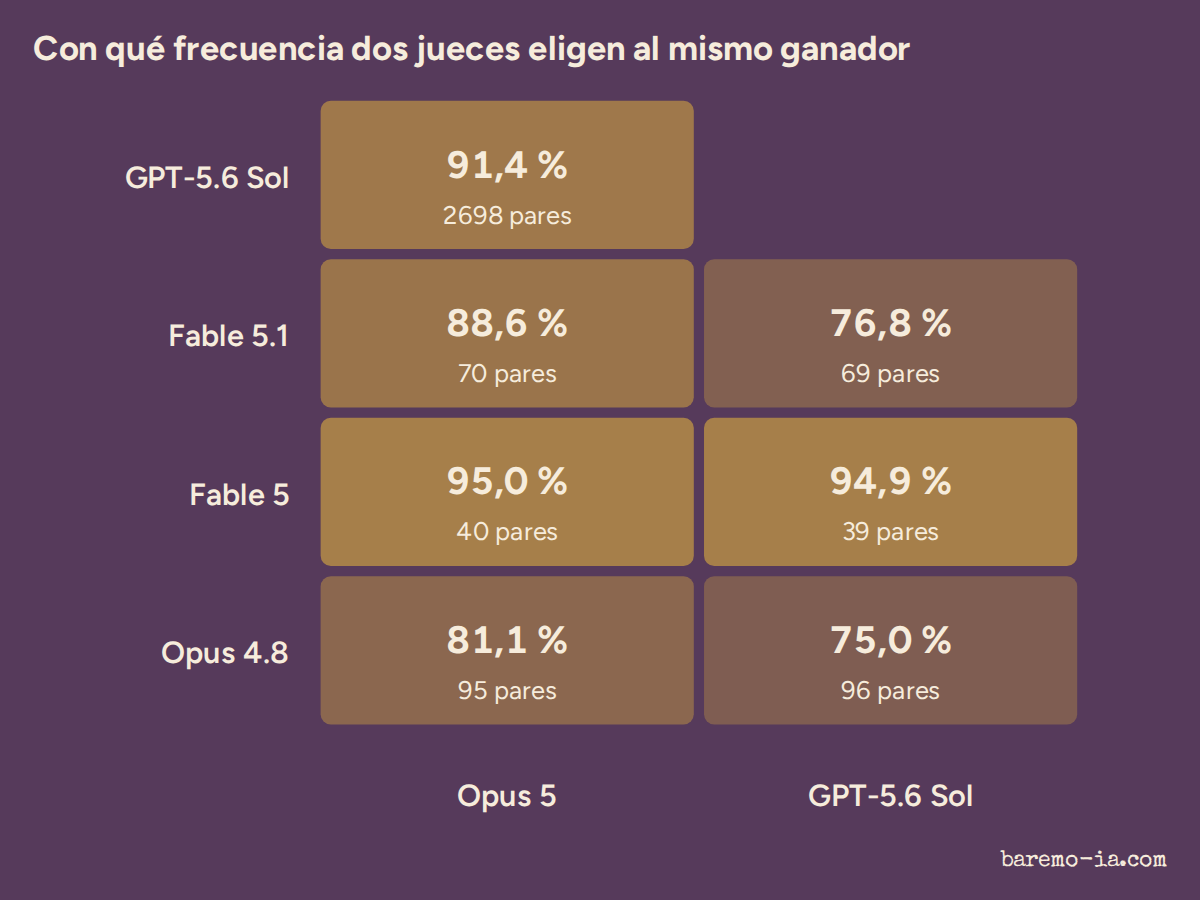
Claude Opus 5 y GPT-5.6 Sol, que aportan el 85 % de los veredictos, dan la razón al mismo modelo en el 91 % de los 2 700 pares de modelos que han juzgado ambos. Claude Opus 4.8 solo coincide con ellos tres de cada cuatro veces, y en los empates nadie se pone de acuerdo: GPT-5.6 Sol declara uno cada 300 duelos, Claude Fable 5.1 uno cada diez.
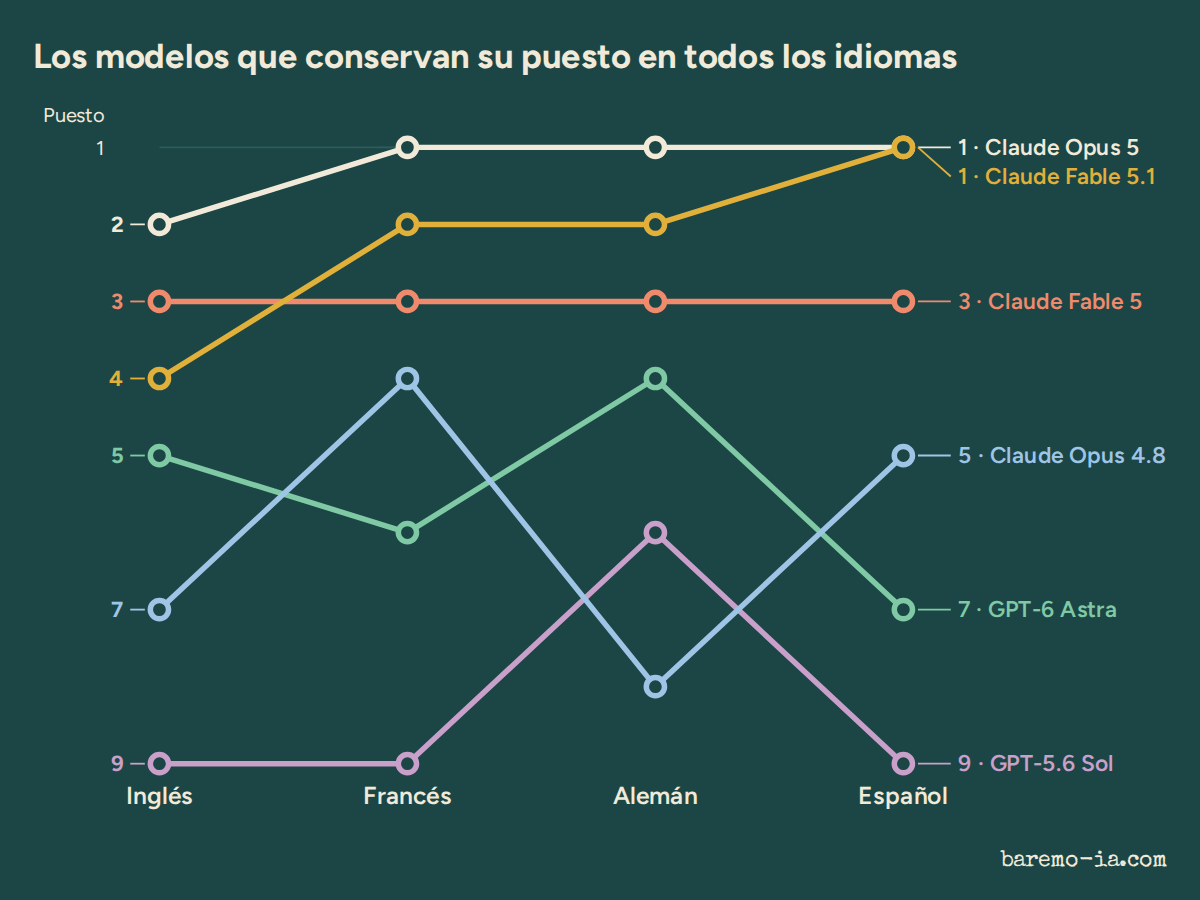
Noventa y un modelos están clasificados en inglés, francés, alemán y español con el mismo protocolo. A 20 de septiembre de 2026, Claude Fable 5 es tercero en los cuatro; Claude Fable 5.1, primero en español. Más abajo, Grok 4.6 es 21.º en español y 60.º en francés, GLM 5.3 Flash 10.º en inglés y 54.º en alemán, y el mejor modelo local cambia con cada idioma.
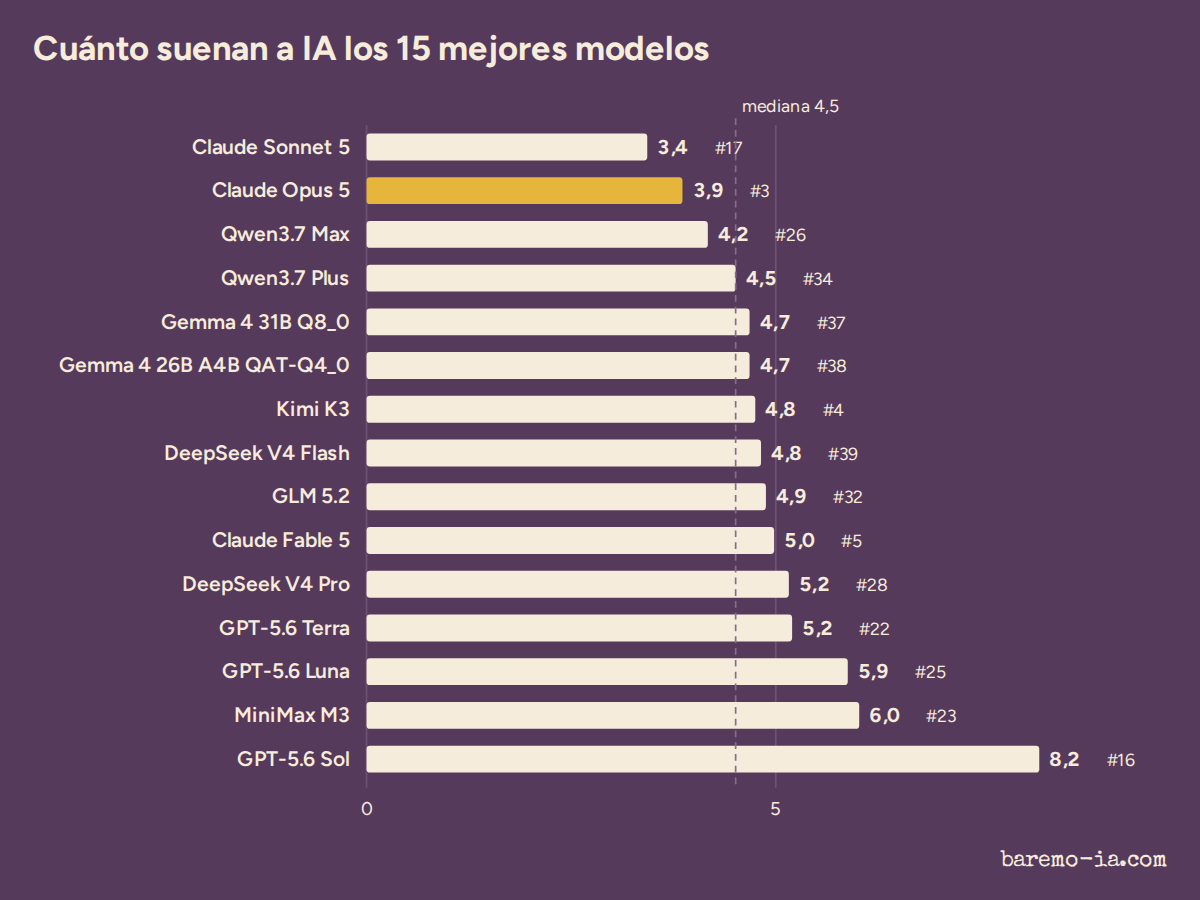
Contamos en 3 084 textos clasificados en español las marcas que los lectores llaman «de IA»: rayas, muletillas, «no X, sino Y», listas de tres, calcos del inglés. Claude Opus 5, segundo de la clasificación el 20 de septiembre de 2026, es también uno de los más sobrios; GPT-5.6 Sol, noveno, el que más marcas deja, con una lista de tres cada 280 palabras. Y «además» aparece 431 veces.