Un mismo modelo, cuatro idiomas: los seis primeros no se mueven, la zona media salta cuarenta puestos
Noventa y un modelos están clasificados en inglés, francés, alemán y español con el mismo protocolo. A 20 de septiembre de 2026, Claude Fable 5 es tercero en los cuatro; Claude Fable 5.1, primero en español. Más abajo, Grok 4.6 es 21.º en español y 60.º en francés, GLM 5.3 Flash 10.º en inglés y 54.º en alemán, y el mejor modelo local cambia con cada idioma.
Las cuatro ediciones de este baremo comparten los mismos modelos, los mismos jueces y el mismo protocolo. Solo cambian las consignas: 240 por idioma, redactadas directamente en cada uno. Así que cuando un modelo es 10.º en inglés y 54.º en alemán, la diferencia no está en el método. Está en el modelo.
Noventa y una variantes de modelo tienen puntuación publicada en los cuatro idiomas. Las cifras y los puestos del texto son los del 20 de septiembre de 2026; los gráficos se recalculan en cada actualización y pueden diferir. Así cambian de puesto de un idioma a otro.
Los seis primeros apenas se mueven: Claude Fable 5 es tercero en todas partes, Claude Fable 5.1 primero en español
Los modelos que conservan su puesto en todos los idiomas
Puesto en cada edición de los seis modelos cuyo puesto menos cambia entre los cuatro idiomas. El puesto 1 está arriba.
Ver como tabla de datos
| Modelo | Inglés | Francés | Alemán | Español |
|---|---|---|---|---|
| Claude Fable 5 | 3 | 3 | 3 | 3 |
| Claude Opus 5 | 2 | 1 | 1 | 1 |
| Claude Fable 5.1 | 4 | 2 | 2 | 1 |
| GPT-5.6 Sol | 9 | 9 | 6 | 9 |
| GPT-6 Astra | 5 | 6 | 4 | 7 |
| Claude Opus 4.8 | 7 | 4 | 8 | 5 |
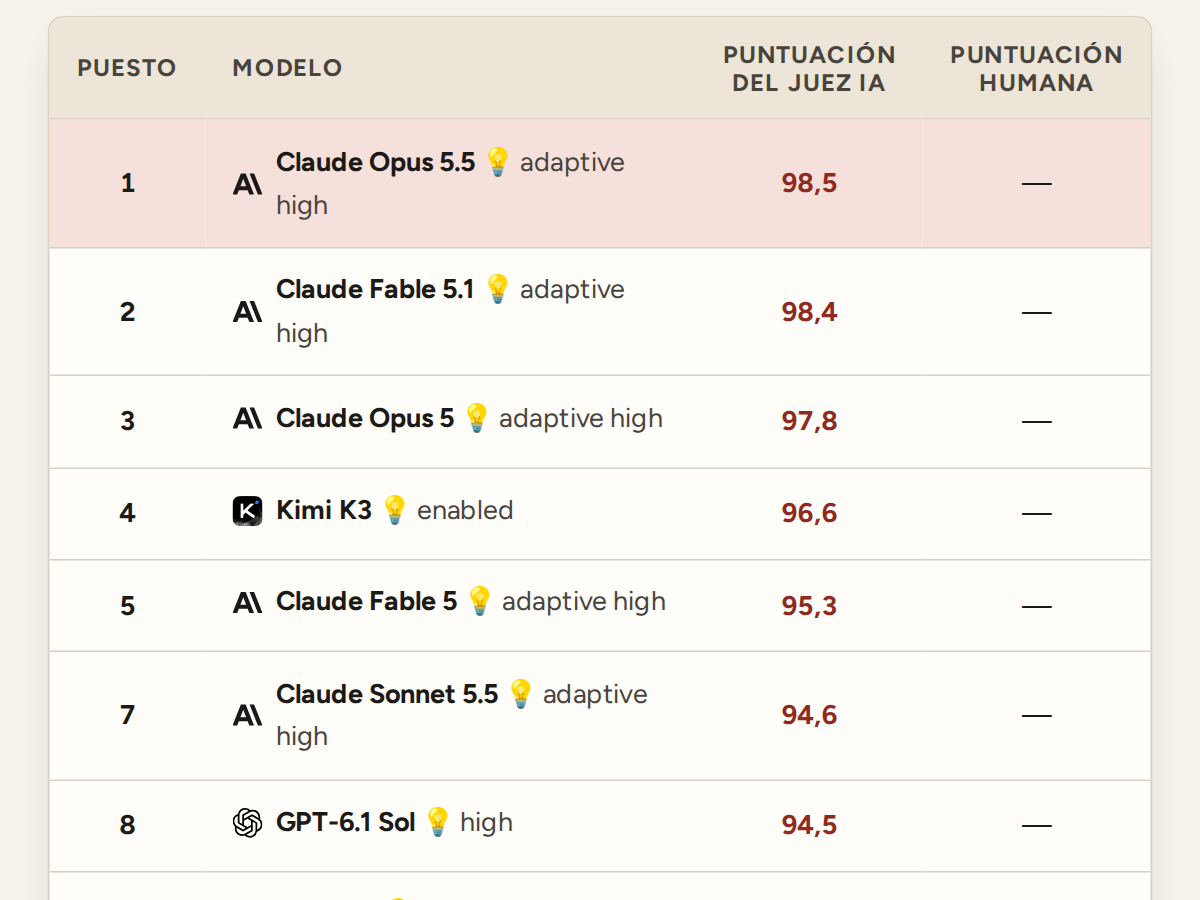
Seis modelos nunca salen de los nueve primeros puestos en ningún idioma: Claude Fable 5, Claude Opus 5, Claude Fable 5.1, GPT-6 Astra, Claude Opus 4.8 y Kimi K3. Kimi K3 es el único de pesos abiertos del grupo; primero en inglés, cuarto en español. GPT-5.6 Sol completa el club, noveno en tres idiomas y sexto en alemán.
Las puntuaciones cuentan lo mismo con un matiz: Claude Fable 5.1 obtiene 98,3 en español y 92,3 en inglés. Significa que el campo español le deja más margen para dominar, no que escriba mejor en español que en inglés. Las puntuaciones solo se comparan dentro de un idioma.
Por debajo de los primeros puestos, un mismo modelo puede ser 10.º en un idioma y 54.º en otro
Un mismo modelo, cuatro puestos
Puesto en cada edición de los seis modelos con mayor dispersión, entre los 91 modelos clasificados en los cuatro idiomas. El puesto 1 está arriba.
Ver como tabla de datos
| Modelo | Inglés | Francés | Alemán | Español |
|---|---|---|---|---|
| GLM 5.3 Flash | 10 | 27 | 54 | 44 |
| Qwen3.8 27B Q4_K_M | 27 | 17 | 58 | 54 |
| Ling 3.0 Flash Q4_K_M | 66 | 35 | 76 | 65 |
| Grok 4.6 | 25 | 60 | 52 | 21 |
| Hy3 | 15 | 43 | 25 | 51 |
| Seed 2.1 Turbo ↯ | 57 | 28 | 61 | 43 |
GLM 5.3 Flash está entre los diez primeros en inglés y en la mitad baja en alemán. Grok 4.6 es fuerte en inglés y en español, 21.º aquí, y flojo en francés y alemán. Hy3 va bien en inglés y regular en todo lo demás, 51.º en español. No son accidentes de muestreo: cada modelo tiene entre 1 000 y 1 800 duelos clasificados por idioma, y los intervalos de confianza miden unos pocos puntos.
Los modelos locales siguen el mismo patrón con un giro más. Qwen3.8 27B en Q4_K_M es el mejor modelo local en francés, 17.º en la general, y uno de los más flojos en alemán, 58.º; en español queda 54.º. El mismo archivo, en la misma máquina, con el mismo ajuste de razonamiento. Lo que Qwen aprendió del francés no lo aprendió del alemán.
El mejor modelo local es distinto en cada idioma, y en español la distancia con la nube es de las mayores
Mejor modelo frente a mejor modelo local
Puntuación del líder de cada edición y de su mejor modelo ejecutado en local. Las puntuaciones solo se comparan dentro de un idioma.
- Mejor modelo
- Mejor modelo local
Ver como tabla de datos
| Mejor modelo | Mejor modelo local | |
|---|---|---|
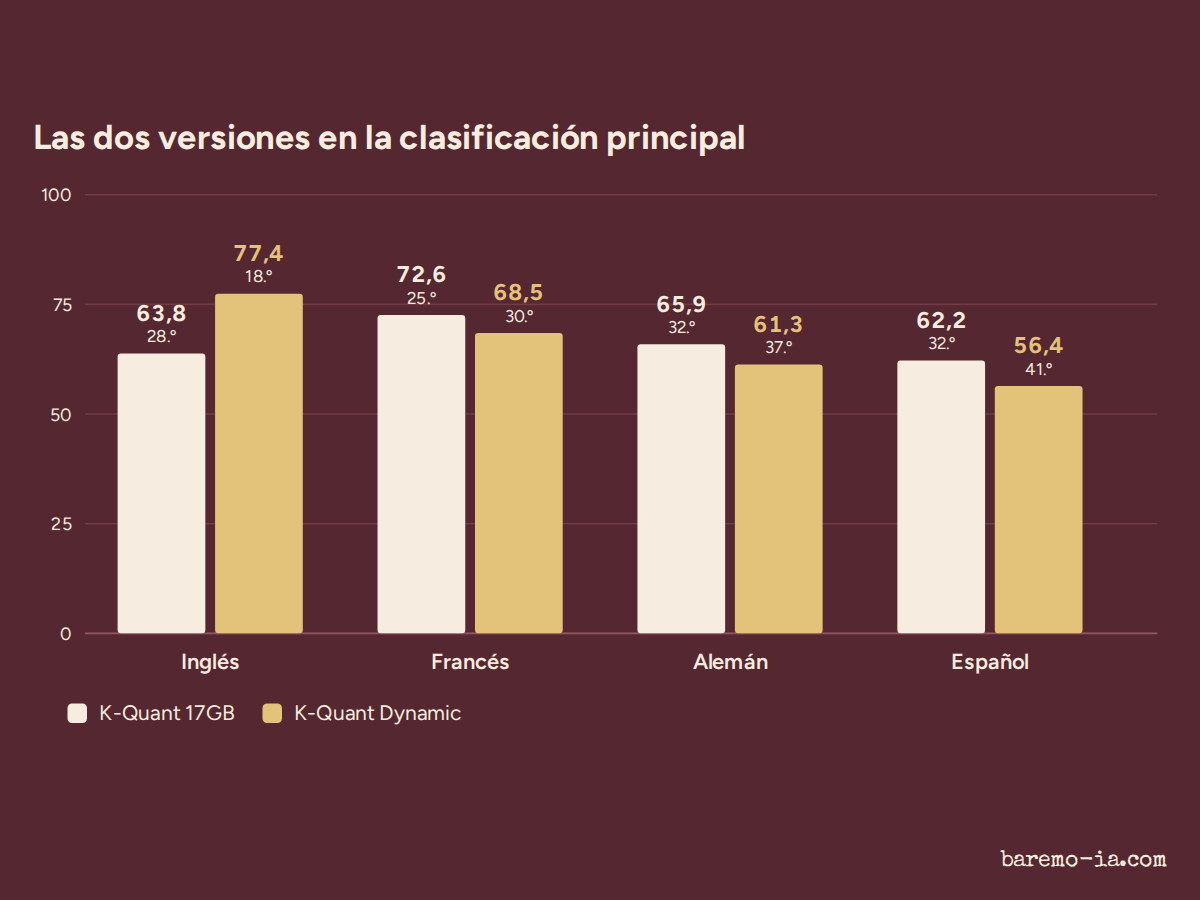
| Inglés | Kimi K3, 93,8 | Muse Glimmer 30B K-Quant Dynamic, 77,4 (18.º) |
| Francés | Claude Opus 5, 99,5 | Qwen3.8 27B Q4_K_M, 76,6 (17.º) |
| Alemán | Claude Opus 5, 98,0 | Gemma 4 31B Q8_0, 72,1 (24.º) |
| Español | Claude Fable 5.1, 98,3 | Qwen3.8 27B Q8_0, 70,4 (23.º) |
Qwen3.8 27B gana el campo local en español y en francés, Muse Glimmer 30B en inglés, Gemma 4 31B en alemán. Nadie que lea una sola clasificación lo adivinaría. En español, 28 puntos separan al mejor modelo local, Qwen3.8 27B Q8_0 con 70,4, del mejor modelo en la nube, Claude Fable 5.1 con 98,3; en inglés son 16, en francés 23, en alemán 26. Cuanto más lejos del inglés, más renuncia una instalación local.
Qué sacar de esto
Leer una clasificación en inglés para elegir un modelo que escriba en español es un error para aproximadamente un tercio del campo. Los modelos cerrados punteros son seguros en todos los idiomas que probamos. Por debajo, lee la edición en español, y si ejecutas modelos en local, comprueba la cuantización concreta: el archivo que gana en un idioma puede perder en el siguiente.
Conclusión
Los modelos punteros son punteros en todos los idiomas; el resto del campo, no. Si escribes en español, una clasificación hecha solo con inglés te engaña sobre un tercio de los modelos: lee la edición en español, y si ejecutas modelos en local, comprueba ahí la cuantización concreta.