Los dos grandes jueces de IA eligen al mismo ganador nueve de cada diez veces. Las discrepancias están en otra parte
Claude Opus 5 y GPT-5.6 Sol, que aportan el 85 % de los veredictos, dan la razón al mismo modelo en el 91 % de los 2 700 pares de modelos que han juzgado ambos. Claude Opus 4.8 solo coincide con ellos tres de cada cuatro veces, y en los empates nadie se pone de acuerdo: GPT-5.6 Sol declara uno cada 300 duelos, Claude Fable 5.1 uno cada diez.
Actualización del 1 de octubre de 2026: las cifras de este artículo son datos a 19 de septiembre de 2026. Desde el 23 de septiembre, Claude Opus 5.5 y GPT-6 Sol sustituyen como jueces a Claude Opus 5 y GPT-5.6 Sol; Muse Spark 1.3 juzga desde el 8 de septiembre. Los veredictos de los jueces anteriores siguen en la clasificación.
A 19 de septiembre, la clasificación reunía los veredictos de seis jueces de IA. Eso solo tiene sentido si, la mayoría de las veces, coinciden. ¿Coinciden?
Lo medimos como lo haría un lector: para cada par de modelos que dos jueces han visto al menos cuatro veces cada uno, ¿dan ambos la mayoría de los puntos al mismo modelo? Los pares que acaban exactamente empatados con alguno de los dos quedan fuera. Edición en español, datos a 19 de septiembre de 2026.
Claude Opus 5 y GPT-5.6 Sol coinciden en el 91 % de sus 2 700 pares compartidos
Con qué frecuencia dos jueces eligen al mismo ganador
Cuota de pares de modelos compartidos en los que ambos jueces dan la mayoría de los puntos al mismo modelo. En pequeño: número de pares compartidos.
Ver como tabla de datos
| Jueces | % | pares |
|---|---|---|
| Claude Opus 5 × GPT-5.6 Sol | 91,4 % | 2698 |
| Claude Opus 5 × Claude Fable 5.1 | 88,6 % | 70 |
| GPT-5.6 Sol × Claude Fable 5.1 | 76,8 % | 69 |
| Claude Opus 5 × Claude Fable 5 | 95,0 % | 40 |
| GPT-5.6 Sol × Claude Fable 5 | 94,9 % | 39 |
| Claude Opus 5 × Claude Opus 4.8 | 81,1 % | 95 |
| GPT-5.6 Sol × Claude Opus 4.8 | 75,0 % | 96 |
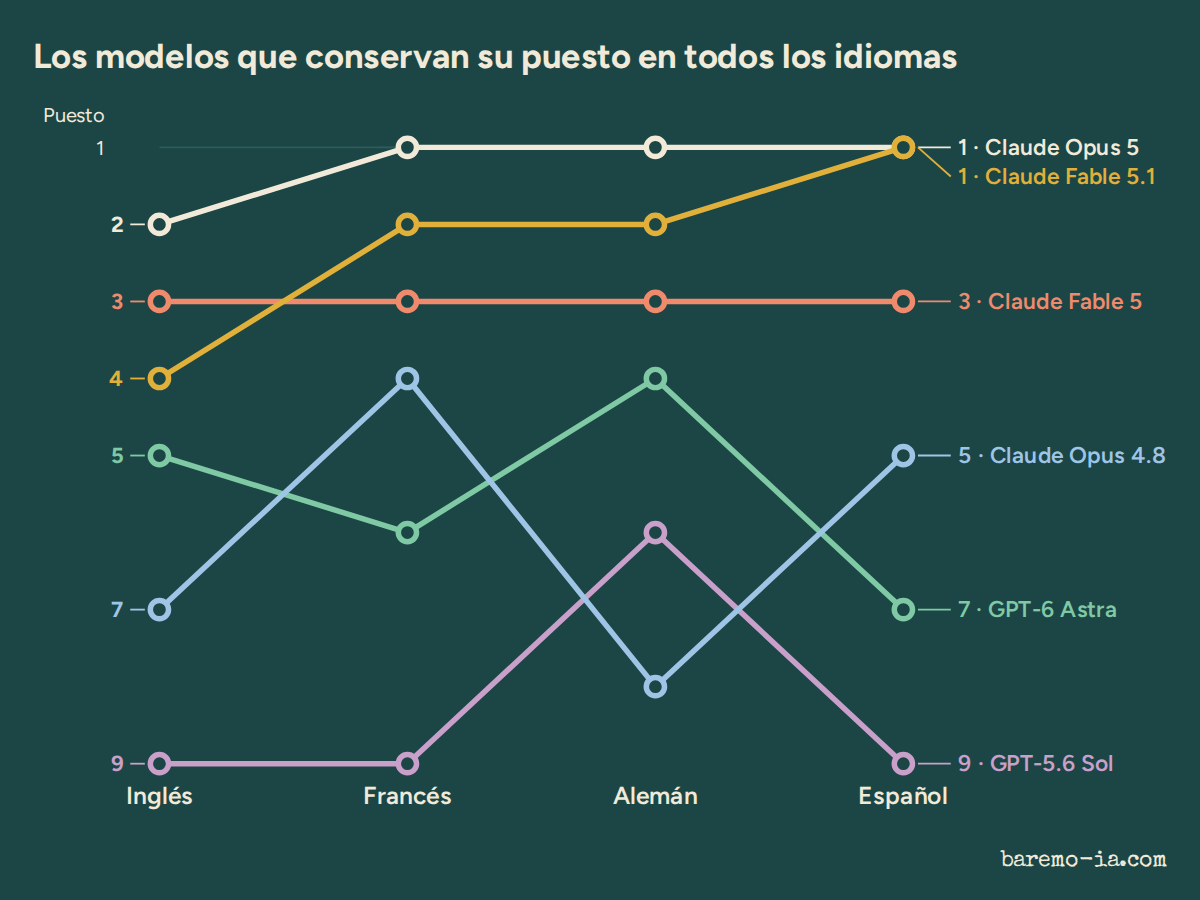
Los dos grandes jueces han juzgado 2 698 pares de modelos en común. Dan la razón al mismo modelo en el 91,4 % de ellos. En inglés, francés y alemán la cifra va del 89 al 93 %.
Dos jueces de empresas distintas, entrenados con datos distintos, que llegan al mismo veredicto en nueve pares de cada diez: es la prueba más sólida que tiene este baremo de que su clasificación mide algo real de la escritura y no el gusto de un solo modelo. El décimo par es donde viven las preguntas interesantes, y publicaremos esas discrepancias como lista.
Claude Opus 4.8, el juez retirado, coincide con los actuales tres de cada cuatro veces
Claude Opus 4.8, la generación anterior de Opus, coincide con Claude Opus 5 en el 81 % de los pares compartidos y con GPT-5.6 Sol en el 75 %. En español se lleva mejor con los jueces actuales que en las otras tres ediciones, donde ronda los dos tercios, pero sus veredictos siguen pareciendo un gusto anterior. Por eso está retirado, con una cuota mínima del total: sus 1 080 veredictos en español se quedan en la clasificación y ya no crecen.
Claude Fable 5.1 coincide mucho más con Claude Opus 5 que con GPT-5.6 Sol
En los pares que comparte con cada uno, Claude Fable 5.1 coincide con Claude Opus 5 el 89 % de las veces y con GPT-5.6 Sol el 77 %. Un aire de familia entre dos jueces Claude no sorprende, pero un baremo que combina sus veredictos debe vigilarlo, y este lo hace. Claude Fable 5, en cambio, coincide por igual con los dos grandes, 95 % en ambos casos, sobre unos 40 pares. Muse Spark 1.3 aún no comparte pares suficientes en español para medirlo.
En los empates los jueces no coinciden en nada: uno cada 300 en GPT-5.6 Sol, uno cada diez en Claude Fable 5.1
Con qué frecuencia cada juez declara un empate
Cuota de veredictos que acaban en empate. En pequeño: veredictos emitidos.
Ver como tabla de datos
| Juez | % | veredictos |
|---|---|---|
| Muse Spark 1.3 | 9,7 % | 5870 |
| Claude Fable 5.1 | 9,5 % | 1829 |
| Claude Fable 5 | 7,7 % | 1014 |
| Claude Opus 4.8 | 5,4 % | 1080 |
| Claude Opus 5 | 3,3 % | 28.548 |
| GPT-5.6 Sol | 0,3 % | 25.244 |
GPT-5.6 Sol casi siempre elige un ganador: el 0,3 % de sus veredictos en español son empates. Claude Fable 5.1 declara empate en el 9,5 % de sus duelos; Muse Spark 1.3, en el 9,7 %. Ninguno de los dos comportamientos es erróneo. El empate es una respuesta legítima cuando dos textos valen lo mismo, y entre modelos punteros ocurre a menudo. Pero significa que una «victoria» bajo Sol es una afirmación más débil que una «victoria» bajo Fable 5.1.
Es una de las razones por las que la clasificación principal usa un ajuste de Bradley–Terry sobre los veredictos, en el que un empate cuenta media victoria para cada lado. Los jueces solo eligen un texto o declaran un empate; no ponen ninguna nota. La tasa de empates de un juez cambia entonces cuánto mueve el ajuste cada uno de sus veredictos, no la dirección.
Qué haremos con esto
Tres cosas. Publicaremos la lista de pares en los que los dos grandes jueces se contradicen. Estamos construyendo una muestra controlada, los mismos pares juzgados por los seis jueces, para que las tasas de acuerdo descansen sobre duelos idénticos. Y las tablas por juez seguirán en la página de resultados, para que quien confíe más en un juez pueda leer la clasificación que ese juez produciría por sí solo.
Conclusión
Dos jueces creados por empresas distintas llegan al mismo veredicto en nueve pares de modelos de cada diez. Es la prueba más sólida que tiene este baremo de que su clasificación mide la escritura y no el gusto de un solo modelo. El décimo par, el gusto más antiguo del juez retirado y las tasas de empate tan distintas son justo lo que el ajuste conjunto de Bradley–Terry está para absorber.