¿Los jueces de IA favorecen a su propio modelo? Dos de cinco, hasta 20 puntos
Cuando GPT-5.6 Sol juzga un duelo en el que participa GPT-5.6 Sol, sus textos se llevan el 93 % de los puntos; bajo los demás jueces, el 72 %. Claude Opus 5 se inclina hacia el mismo lado, con menos fuerza. Los dos jueces Claude Fable hacen lo contrario y puntúan su modelo por debajo de lo que hacen los demás.
Cada juez de este baremo recibe dos textos anónimos y elige el mejor. Anónimos para el juez, no para nosotros: sabemos quién escribió cada texto. Eso permite hacer una pregunta que el juez no puede hacerse: cuando uno de los dos textos viene de su propio modelo, ¿cambia el veredicto?
En dos jueces, sí. El gráfico compara, para cada juez, la cuota de puntos que reúne su modelo cuando decide él con la que reúne ese mismo modelo bajo todos los demás jueces. Una victoria vale un punto; un empate, medio. Datos: todos los duelos en español publicados a 19 de septiembre de 2026, unos 64 000 veredictos.
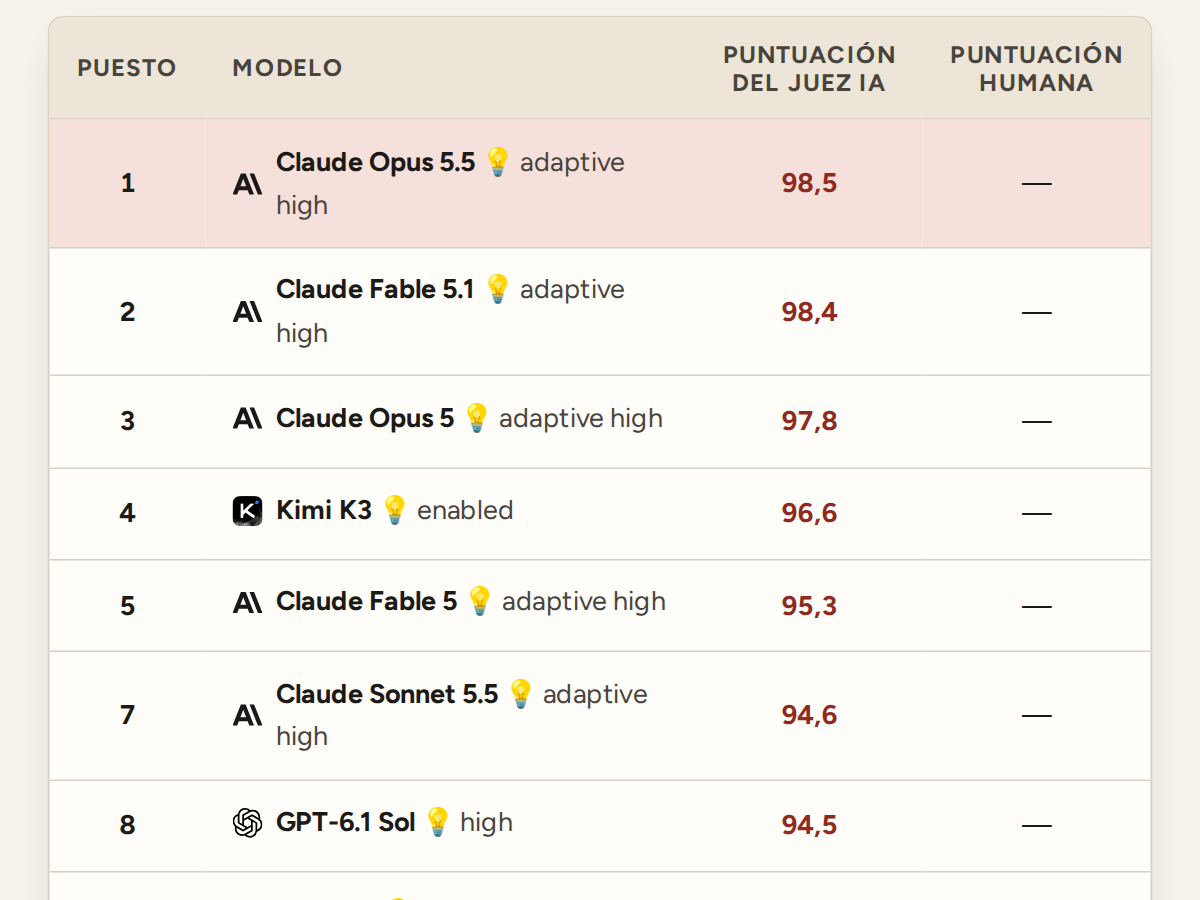
Actualización del 1 de octubre de 2026: los jueces actuales también juzgan parejas en las que participa su propio modelo. Con el mismo método, GPT-6 Sol da a GPT-6 Sol el 95,3 % de los puntos cuando juzga él y el 87,3 % bajo los demás jueces, ocho puntos de diferencia sobre 436 duelos autojuzgados. Claude Opus 5.5 apenas se favorece: 98,1 % frente a 97,2 %, sobre 606 duelos. Muse Spark 1.3 sigue sin favorecerse: 75,1 % frente a 79,1 %, sobre 255 duelos. El resto del artículo describe los datos a 19 de septiembre.
GPT-5.6 Sol regala 20 puntos a sus propios textos; Claude Opus 5, cinco
El modelo de cada juez, bajo sus propios veredictos y bajo los de los demás
Cuota de puntos que reúne el modelo (una victoria vale 1, un empate ½) cuando juzga su propio modelo y cuando deciden los demás jueces.
- Bajo su propio juez
- Bajo los demás jueces
Ver como tabla de datos
| Juez | Bajo su propio juez | Bajo los demás jueces | Bonificación del juez propio | n |
|---|---|---|---|---|
| GPT-5.6 Sol | 92,7 % | 72,4 % | +20,3 | 1056 |
| Claude Opus 5 | 96,9 % | 91,4 % | +5,5 | 810 |
| Muse Spark 1.3 | 79,3 % | 80,0 % | −0,7 | 135 |
| Claude Fable 5 | 91,0 % | 93,8 % | −2,8 | 909 |
| Claude Fable 5.1 | 90,6 % | 96,1 % | −5,5 | 191 |
GPT-5.6 Sol es el caso más claro: el 92,7 % de los puntos cuando juzga Sol, el 72,4 % cuando juzga cualquier otro, sobre algo más de mil duelos autojuzgados. Es la mayor diferencia de las cuatro ediciones. Claude Opus 5 se inclina hacia el mismo lado con menos margen: 96,9 % frente a 91,4 %. Muse Spark 1.3, en cambio, no se favorece en español (79,3 % frente a 80,0 %), aunque con 135 duelos la muestra es pequeña.
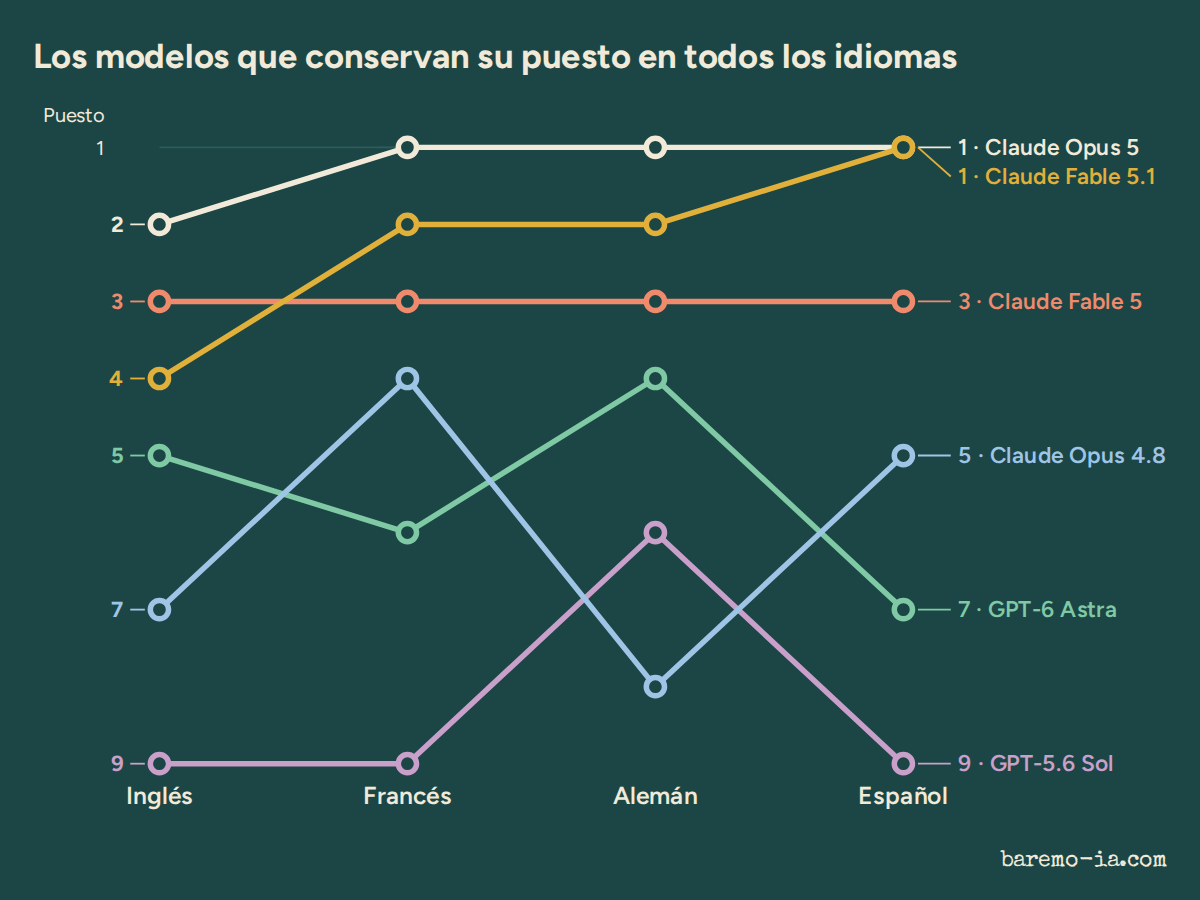
El mismo patrón aparece en inglés, francés y alemán, con una bonificación de Sol de entre 15 y 20 puntos en cada caso. No es una peculiaridad del corpus español.
Claude Fable 5 y Claude Fable 5.1 puntúan su modelo por debajo de los demás
Los dos jueces Fable van en sentido contrario. Bajo sus propios veredictos, sus textos consiguen menos puntos que bajo los demás jueces: 91,0 % frente a 93,8 % en Fable 5, 90,6 % frente a 96,1 % en Fable 5.1. Entre tres y cinco puntos de penalización, otra vez en los cuatro idiomas. Sea cual sea el motivo, no se hacen favores.
Por qué importa la bonificación: dos jueces aportan el 85 % de los veredictos
La bonificación de un juez minoritario se diluiría en la clasificación conjunta. Aquí no puede: Claude Opus 5 y GPT-5.6 Sol producen el 85 % de todos los veredictos. Unos 800 duelos Opus-sobre-Opus y 1 000 duelos Sol-sobre-Sol entran en el ajuste de Bradley–Terry junto con todos los demás, y pesan.
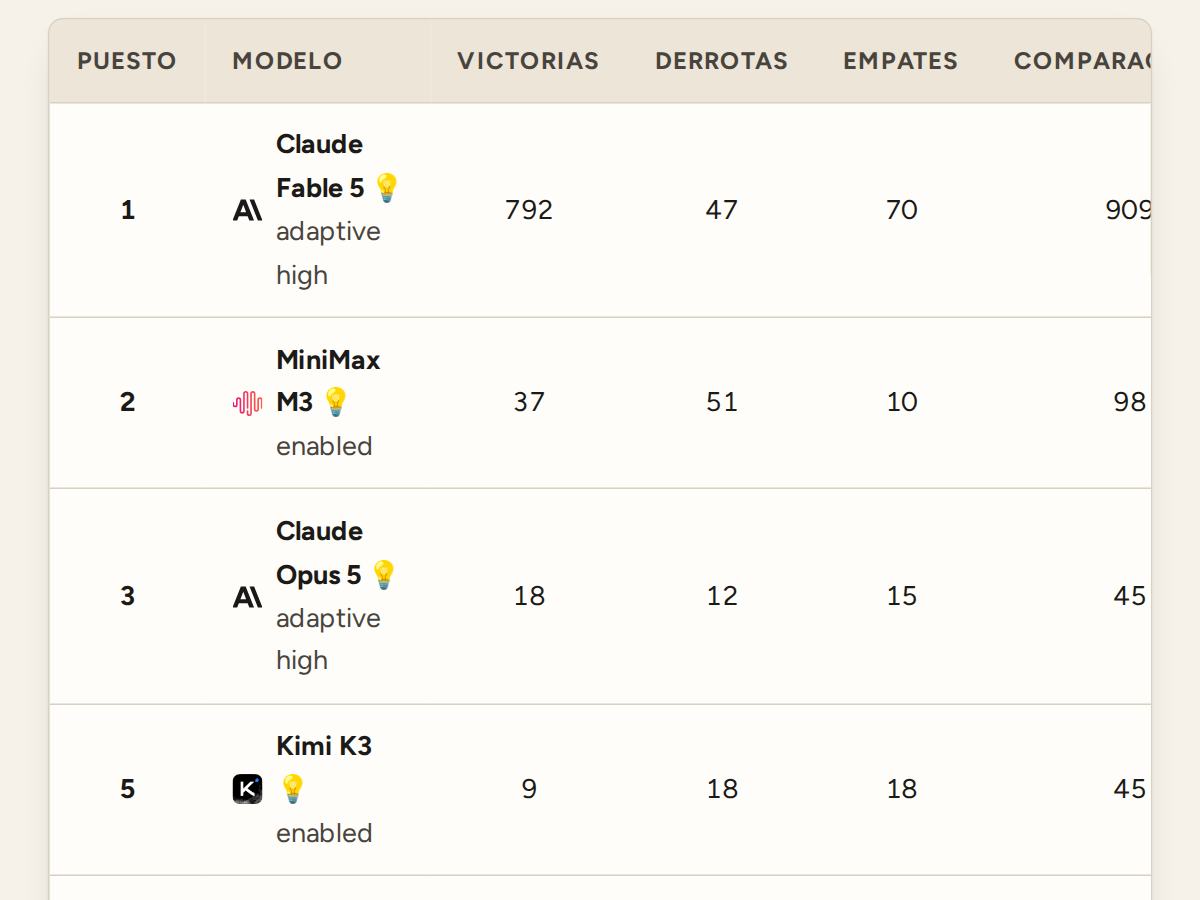
Se veía, a 19 de septiembre, en las tablas por juez: GPT-5.6 Sol colocaba a su propio modelo segundo cuando juzgaba solo, mientras que la clasificación conjunta lo dejaba noveno. Claude Opus 5 era primero o segundo en las dos, así que su bonificación no cambiaba la cabeza, pero inflaba igualmente su puntuación.
Por qué todavía no lo llamamos sesgo
Dos reservas nos frenan. La primera: los duelos no son los mismos. Bajo su propio juez, un modelo se enfrenta a una mezcla de rivales distinta de la que encuentra bajo los demás, y esa mezcla cambia la cuota esperada. La diferencia de Sol es demasiado grande para explicarse solo así, pero en parte sí. La segunda: «los demás jueces» no es un instrumento neutral: cuando miramos a Sol son sobre todo Opus 5, y cuando miramos a Opus 5 son sobre todo Sol. Si uno es severo con el otro, esa severidad cae en la misma fila.
La prueba limpia es una muestra controlada, los mismos pares juzgados por todos los jueces, y una clasificación que excluya los duelos autojuzgados. Ninguna de las dos está publicada todavía; hasta entonces, esta página repetirá el cálculo con los jueces en activo, como en la actualización del 1 de octubre de 2026.
Conclusión
La autopreferencia existe en dos jueces y no en otros dos. Como Claude Opus 5 y GPT-5.6 Sol aportan el 85 % de los veredictos, su bonificación puede subir unos puestos a sus propios modelos en la clasificación principal. El siguiente paso es una clasificación calculada sin los duelos autojuzgados, para ver exactamente cuánto se mueve.