Los modelos se ordenan por la calidad de sus textos en español. Usa los filtros para acotar la lista. Para las categorías de escritura seleccionadas, los puestos se calculan antes de aplicar los filtros de proveedor, tamaño, acceso, razonamiento y cuantización; por eso los modelos ocultos pueden dejar huecos.
Última actualización:
Clasificación de modelos de escritura basada en resultados por pares
Puesto
Modelo
Puntuación
del juez IA
Puntuación
humana
1
Claude Opus 5.5 💡 adaptive high
98,5
—
2
Claude Fable 5.1 💡 adaptive high
98,1
—
3
Claude Opus 5 💡 adaptive high
97,8
—
4
Kimi K3 💡 enabled
96,4
—
5
GPT-6.1 Sol 💡 high
95,7
—
6
Claude Fable 5 💡 adaptive high
95,2
—
8
GPT-6 Astra 💡 high
94,6
—
9
GLM 5.3 💡 max
94,0
—
10
Claude Sonnet 5.5 💡 adaptive high
93,7
—
11
GPT-6 Sol 💡 high
92,5
—
12
Muse Spark 1.2 💡 high
91,4
—
13
Grok 4.7 💡 high
88,8
—
14
DeepSeek V4.1 Flash 💡 high
87,8
—
15
Muse Spark 1.3 💡 high
87,3
—
16
GPT-5.6 Sol 💡 high
85,2
—
17
Aion 3.5 💡 high
85,0
—
18
Gemini 3.8 Flash 💡 high
84,6
—
19
Claude Sonnet 5 💡 adaptive high
84,4
—
20
Ling 3.1 Flash 💡 high
83,8
—
21
Qwen3.8 Max 💡 xhigh
83,5
—
23
GPT-5.6 Terra 💡 high
82,6
—
24
GPT-6 Luna 💡 high
81,8
—
25
MiMo V2.6 Pro fp8 💡 high
80,1
—
26
MiniMax M3 💡 enabled
79,8
—
27
GPT-5.6 Luna 💡 high
77,2
—
28
Qwen3.7 Max 💡 enabled
74,7
—
29
DeepSeek V4 Pro 💡 enabled
73,3
—
30
Claude Haiku 5.5 💡 adaptive high
73,1
—
31
Grok 4.6 💡 high
71,5
—
32
Inkling 💡 high
70,6
—
33
Qwen3.8 Flash 💡 high
69,6
—
34
GLM 5.2 💡 enabled
67,6
—
35
Qwen3.8 27B Q8_0 💡 xhigh** 🏠
65,2
—
36
Qwen3.7 Plus 💡 enabled
64,5
—
37
Hy4 Preview 💡 high
62,3
—
38
Gemma 4 31B Q8_0 💡 on* 🏠
61,6
—
40
Gemini 3.7 Flash 💡 medium
59,6
—
41
DeepSeek V4 Flash 💡 enabled
59,5
—
45
Gemma 4 26B A4B Q8_0 ↯ 🏠
58,0
—
46
Gemma 4 31B Q8_0 ↯ 🏠
57,9
—
48
Mistral Large 4 💡 high
55,6
—
49
Seed 2.1 Turbo ↯
53,9
—
52
Gemma 4 26B A4B Q8_0 💡 on* 🏠
51,3
—
55
Aion 3.0 💡 mandatory
46,6
—
56
Gemma 4 12B Q8_0 💡 on* 🏠
45,8
—
58
GLM 5.3 Flash 💡 high
44,2
—
60
Hy3 💡 high
43,0
—
61
Qwen3.6 27B Q8_0 💡 on* 🏠
42,9
—
62
MiMo V2.5 Pro 💡 enabled
42,3
—
64
Gemma 4 12B Q8_0 ↯ 🏠
40,6
—
67
MiMo V2.6 Flash 💡 high
38,9
—
68
Qwen3.6 35B A3B Q8_0 💡 on* 🏠
38,2
—
69
Nemotron 3 Ultra 💡 high
37,9
—
71
Qwen3.8 27B Q8_0 ↯ 🏠
34,7
—
78
Agnes 3.0 Flash 💡 high
25,7
—
80
Mistral Medium 3.5 💡 high
22,1
—
82
Nemotron 3.5 Lightning 💡 high
17,4
—
82
Qwen3.6 35B A3B Q8_0 ↯ 🏠
17,4
—
85
Gemma 4 E4B Q8_0 💡 on* 🏠
14,8
—
86
Gemma 4 E2B Q8_0 💡 on* 🏠
14,4
—
89
Qwen3.6 27B Q8_0 ↯ 🏠
12,9
—
90
MiMo V2.5 💡 enabled
12,6
—
91
Gemma 4 E2B Q8_0 ↯ 🏠
12,2
—
93
MiniMax M3.1 Flash 💡 high
11,2
—
98
Gemma 4 E4B Q8_0 ↯ 🏠
10,0
—
102
Granite 4.2 30B Q8_0 💡 full 🏠
7,3
—
106
Nemotron 3 Nano Omni 30B A3B Q8_0 💡 on* 🏠
6,3
—
108
Granite 4.2 8B Q8_0 💡 full 🏠
1,9
—
Todavía no hay resultados publicados para esta selección
Un modelo aparece tras su primera evaluación individual publicada; su puntuación de clasificación aparece tras su primer duelo admisible.
108 modelos comparados · 106.327 veredictos de IA publicados
Método: modelo de Bradley–Terry regularizado. La puntuación del juez IA determina el puesto; la puntuación humana es independiente y sigue siendo secundaria hasta que haya más votos de la comunidad. Una puntuación de 50 equivale a una probabilidad estimada de una entre dos de superar al modelo medio en este idioma y categoría.
Resultados de los duelos directos
Cada celda muestra la proporción de puntos posibles que obtiene el modelo de la fila frente al modelo de la columna: una victoria vale el 100 %, un empate el 50 % y una derrota el 0 %. Esta matriz solo usa los protocolos de evaluación compatibles con la clasificación principal.
Matriz direccional de los puntos obtenidos en duelos directos. Por encima del 50 % favorece al modelo de la fila; por debajo, al de la columna.
0 %100 %
💡 indica un modelo con razonamiento, ↯ uno sin razonamiento. 🏠 indica un modelo ejecutado localmente en el ordenador del autor de este sitio.«on*» indica un razonamiento que solo se activa o se desactiva (modelos locales sin niveles intermedios): el nivel solicitado, high, no está disponible en el archivo local, que usa el modo activado por defecto. En los modelos locales con razonamiento ajustable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), el nivel mostrado (xhigh**, high, full) es el nivel por defecto del modelo: el nivel solicitado no está disponible en el archivo local, que usa su nivel por defecto.
Ver como tabla
Puntos obtenidos en duelos directos por pareja de modelos
Modelo
Cobertura de duelos publicados
Cada celda muestra cuántos duelos juzgados por IA y publicados, en todos los protocolos, comparan los dos modelos para este idioma y categoría. Los modelos de ambos ejes son candidatos; la matriz no indica qué juez emitió cada veredicto.
Matriz simétrica del número de duelos publicados. La diagonal es cero porque un modelo no se compara consigo mismo.
0
💡 indica un modelo con razonamiento, ↯ uno sin razonamiento. 🏠 indica un modelo ejecutado localmente en el ordenador del autor de este sitio.«on*» indica un razonamiento que solo se activa o se desactiva (modelos locales sin niveles intermedios): el nivel solicitado, high, no está disponible en el archivo local, que usa el modo activado por defecto. En los modelos locales con razonamiento ajustable (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash), el nivel mostrado (xhigh**, high, full) es el nivel por defecto del modelo: el nivel solicitado no está disponible en el archivo local, que usa su nivel por defecto.
Ver como tabla
Duelos publicados por pareja de modelos
Modelo
Ayuda a elegir el mejor modelo para escribir en español
¿Qué modelo escribe el mejor texto? Juzga esta pareja anónima y contribuye a la clasificación humana. Durante el duelo no verás qué modelo escribió cada texto. Los nombres se revelan al terminar.
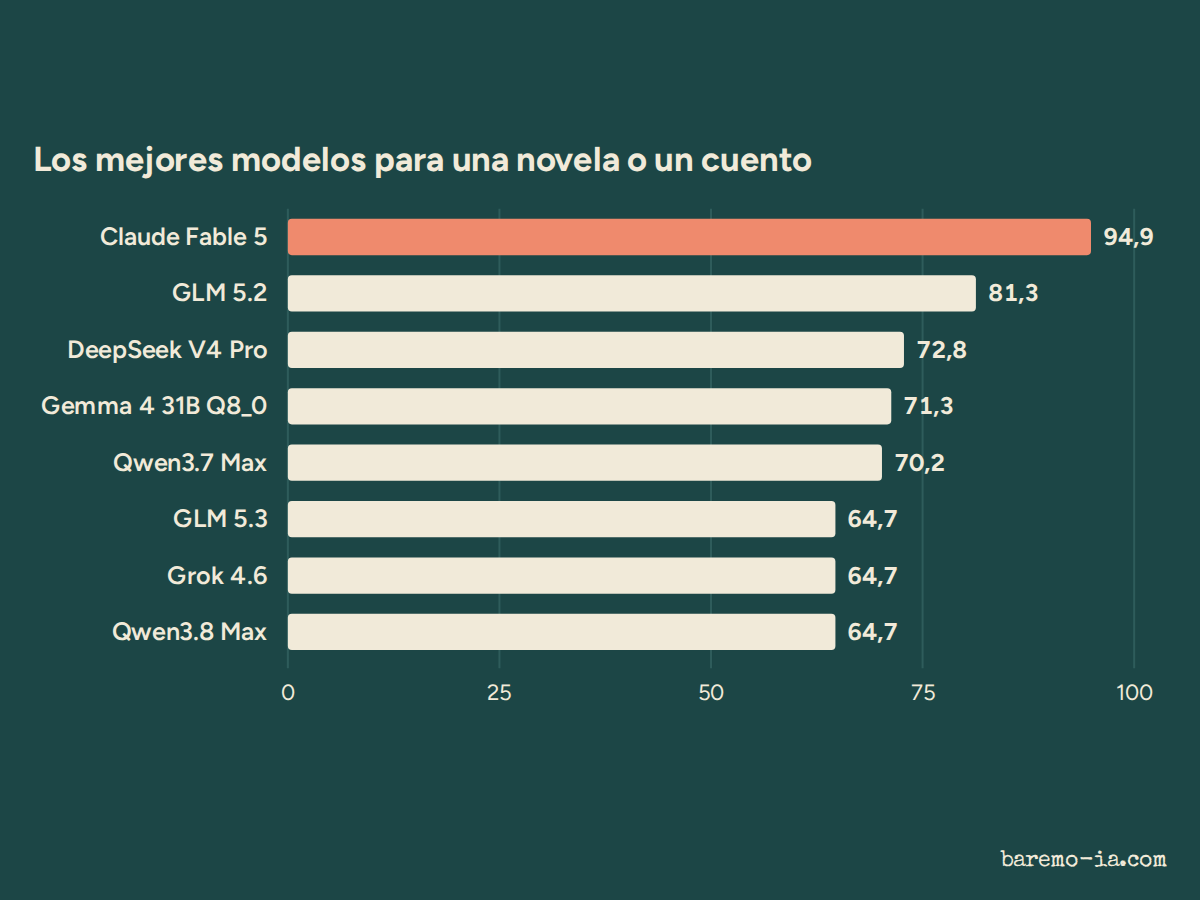
La clasificación tiene un ganador; tus textos tienen varios. Solo con los duelos de un tipo de texto, a 20 de septiembre de 2026, Claude Fable 5 gana la ficción, Claude Opus 5 los correos personales, Claude Fable 5.1 las cartas de presentación y Kimi K3 las explicaciones. Una guía sencilla, tarea por tarea, con el mejor archivo para tu propio ordenador.
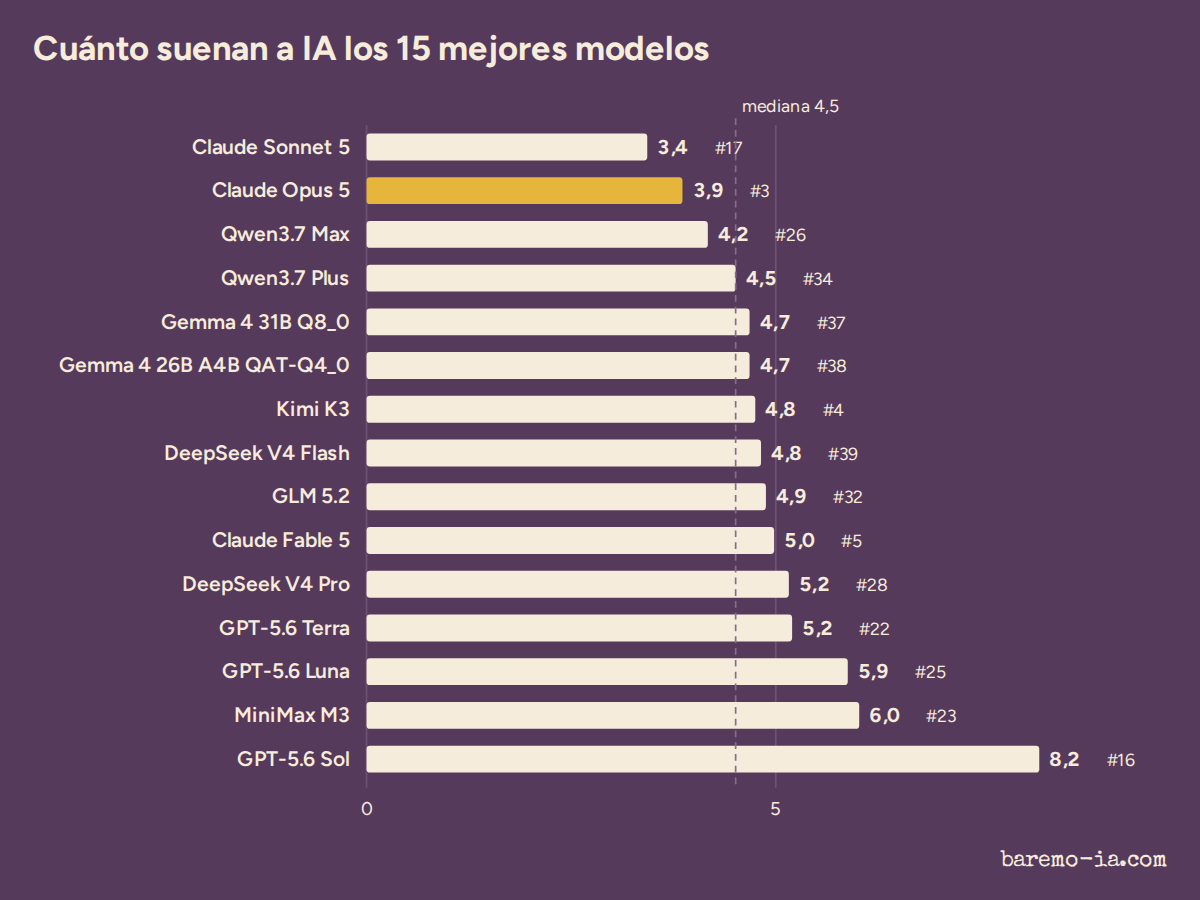
Contamos en 3 084 textos clasificados en español las marcas que los lectores llaman «de IA»: rayas, muletillas, «no X, sino Y», listas de tres, calcos del inglés. Claude Opus 5, segundo de la clasificación el 20 de septiembre de 2026, es también uno de los más sobrios; GPT-5.6 Sol, noveno, el que más marcas deja, con una lista de tres cada 280 palabras. Y «además» aparece 431 veces.
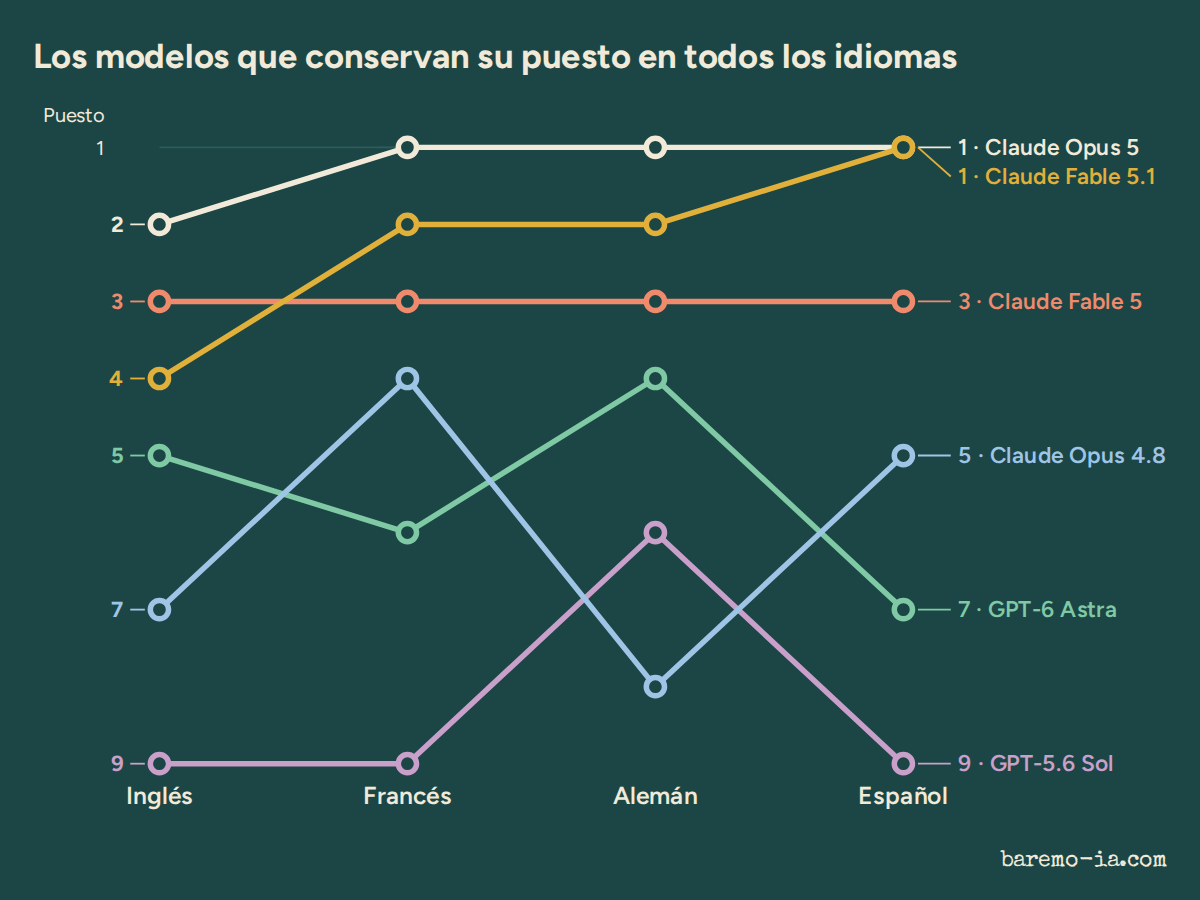
Noventa y un modelos están clasificados en inglés, francés, alemán y español con el mismo protocolo. A 20 de septiembre de 2026, Claude Fable 5 es tercero en los cuatro; Claude Fable 5.1, primero en español. Más abajo, Grok 4.6 es 21.º en español y 60.º en francés, GLM 5.3 Flash 10.º en inglés y 54.º en alemán, y el mejor modelo local cambia con cada idioma.
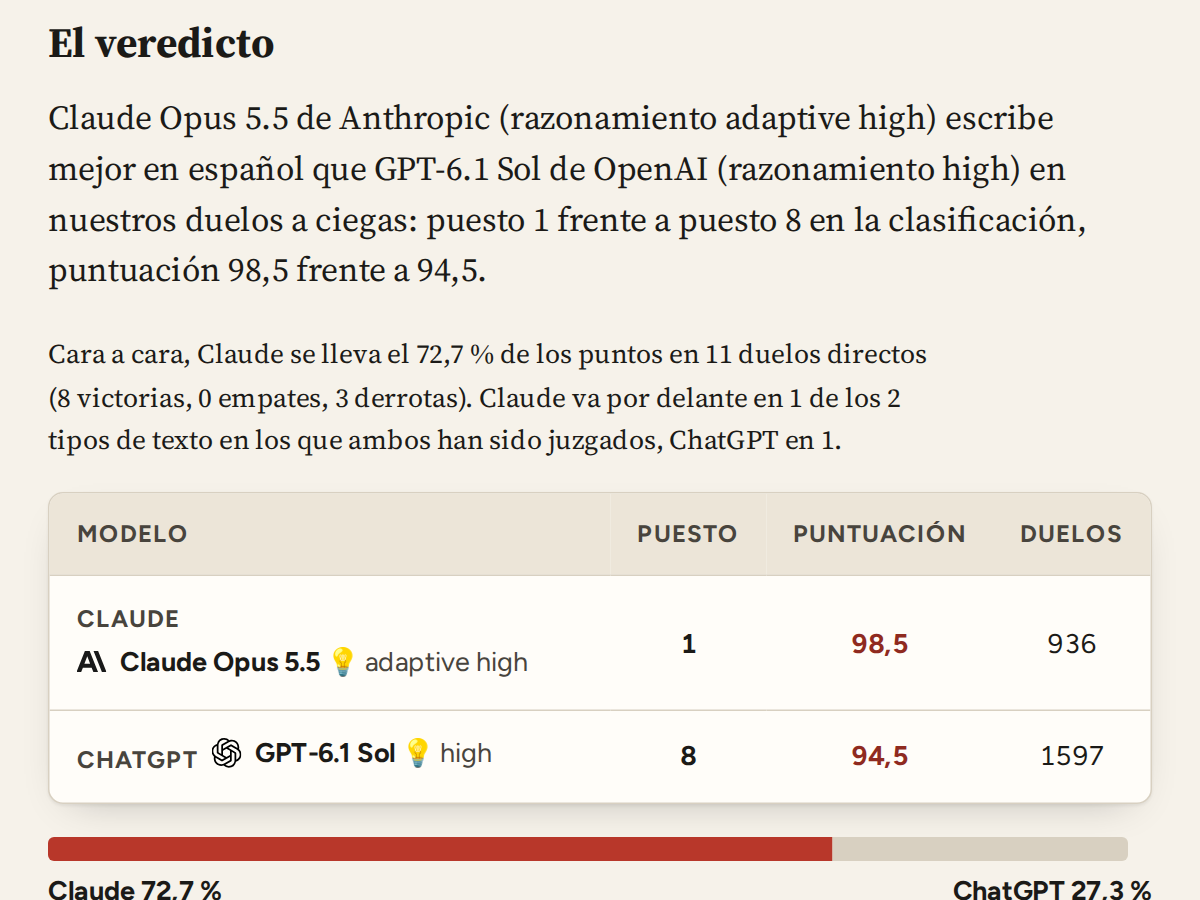
Los dos asistentes por los que más se pregunta, juzgados con las mismas consignas en español en duelos a ciegas: cuál escribe mejor, por cuánto y en qué tipos de texto. Se actualiza con cada exportación de la clasificación.
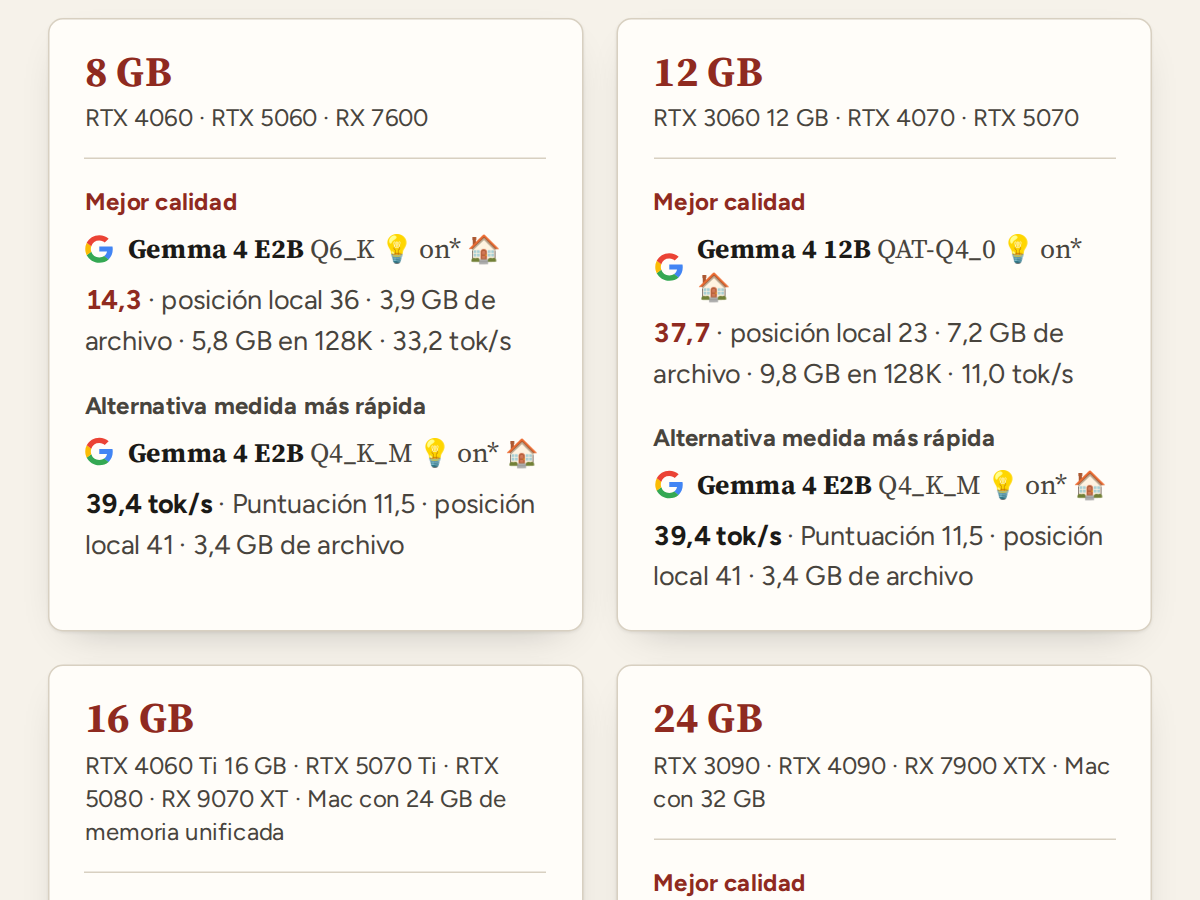
La clasificación viva de los modelos de pesos abiertos para escribir en español, la memoria que necesita cada archivo y lo que cabe en 16, 24, 32 o 128 GB.